
Texto completo del discurso de Huang Renxun en GTC: para 2027, la demanda del mercado superará $1B; todos deberían desarrollar una estrategia para OpenClaw

 Prefiérenos en Google


Título original: «Texto completo del discurso de Jensen Huang en GTC: llega la era de la inferencia, ingresos de $1B para 2027, las langostas son el nuevo sistema operativo»
Autor original: Bao Yilong, Wall Street View
El 16/03/2026, se inauguró oficialmente la conferencia NVIDIA GTC 2026, y Jensen Huang, fundador y director ejecutivo de NVIDIA, pronunció el discurso principal.
En esta conferencia, considerada la «peregrinación anual de la industria de la IA», Jensen Huang describió la transformación de NVIDIA, de «empresa de chips» a «empresa de infraestructura y fábricas de IA». Ante las principales preocupaciones del mercado sobre la sostenibilidad del rendimiento y el potencial de crecimiento, Jensen Huang detalló la lógica empresarial subyacente que impulsará el crecimiento futuro: la «economía de las fábricas de tokens».
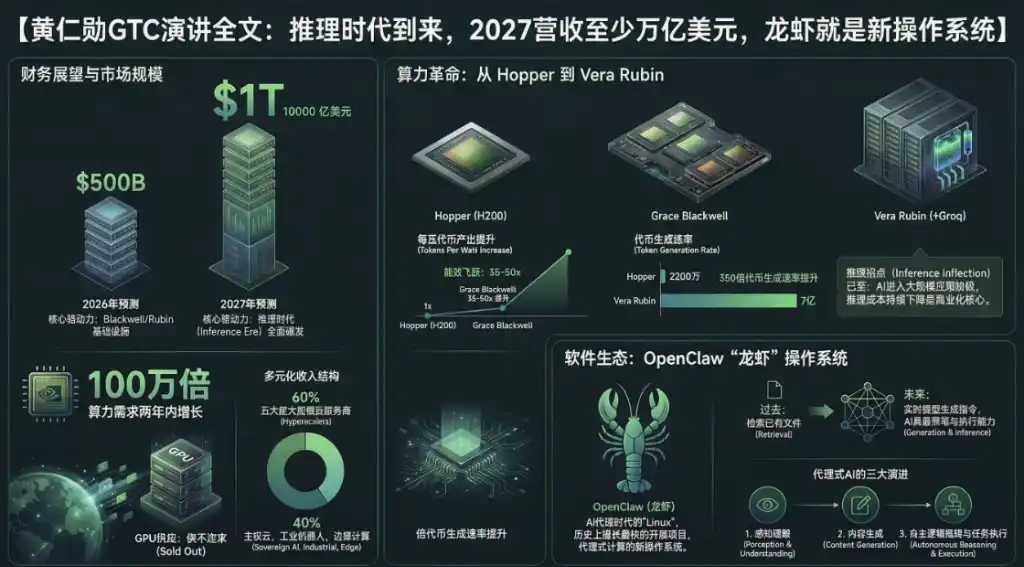
Previsiones de rendimiento extremadamente optimistas: «al menos $1B de demanda para 2027»
En los últimos dos años, la demanda mundial de computación para IA ha experimentado una explosión exponencial. A medida que los modelos grandes evolucionan de la «percepción» y la «generación» a la «inferencia» y la «acción (ejecución de tareas)», el consumo de potencia de cálculo ha aumentado drásticamente. Frente al intenso interés del mercado por los pedidos y los límites de ingresos, Jensen Huang ofreció unas perspectivas muy sólidas.
Jensen Huang afirmó en su discurso:
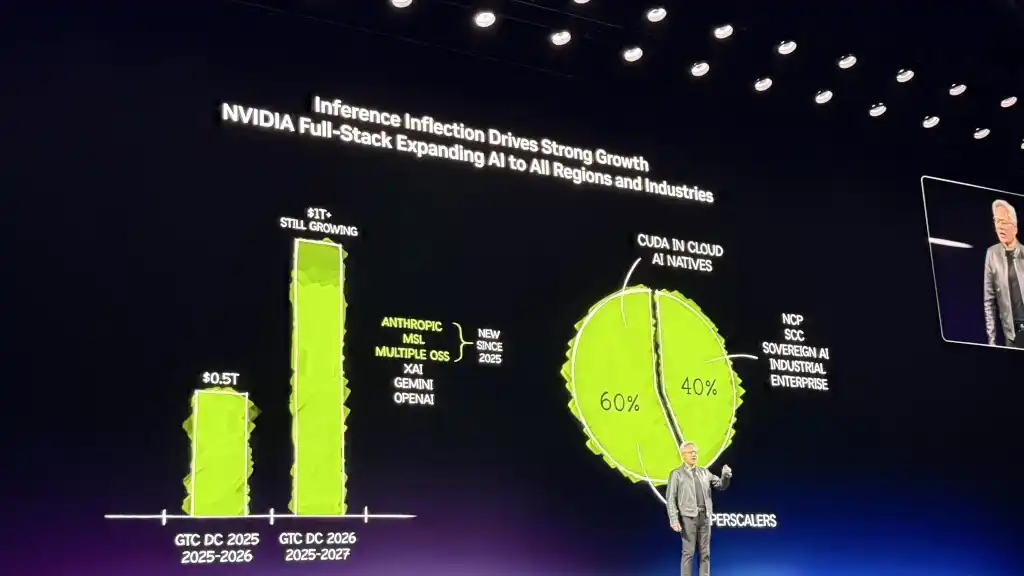
En esta misma época el año pasado, dije que veíamos una demanda de $500.000 M con un alto grado de confianza, que abarcaba Blackwell y Rubin hasta 2026. Ahora, aquí y en este momento, veo una demanda de al menos $1B para 2027.
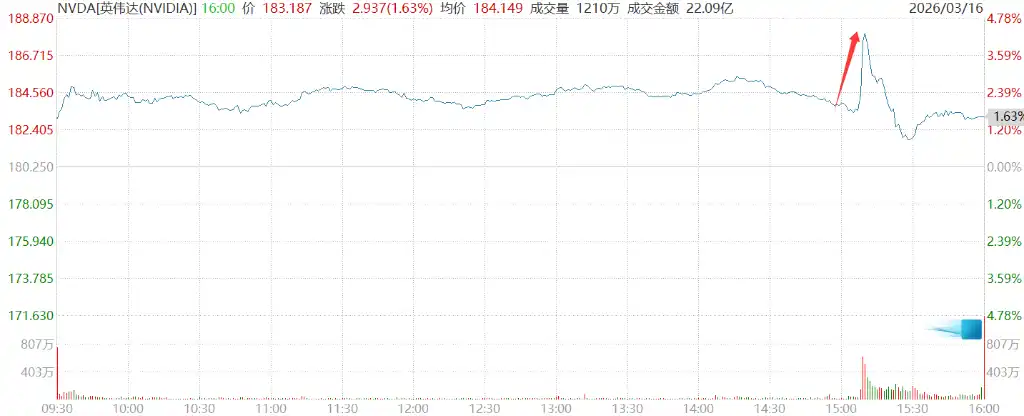
La expectativa de Jensen Huang de alcanzar el billón de dólares impulsó en su momento el precio de las acciones de NVIDIA hasta más de 4,3%.
Además, amplió la explicación de esta cifra:
¿Es razonable? Eso es lo que voy a abordar ahora. De hecho, ni siquiera podremos satisfacer la demanda. Estoy seguro de que la demanda real de computación será mucho mayor que esto.
Jensen Huang señaló que los sistemas de NVIDIA han demostrado ser hoy la «infraestructura de menor costo» del mundo. Como NVIDIA puede ejecutar modelos de IA en casi todos los ámbitos, esta versatilidad permite aprovechar plenamente la inversión de $1B que realizan los clientes y mantenerla durante un ciclo de vida prolongado.
Actualmente, 60% del negocio de NVIDIA proviene de los cinco principales proveedores de nube a hiperescala, mientras que el 40% restante se distribuye ampliamente entre nubes soberanas, empresas, industrias, robótica, computación en el borde y otros ámbitos.
Economía de las fábricas de tokens: el éxito empresarial depende del rendimiento por vatio
Para explicar la lógica detrás de esta demanda de un billón de dólares, Jensen Huang presentó a los directores ejecutivos de todo el mundo un nuevo conjunto de conceptos empresariales. Señaló que el centro de datos del futuro ya no será un almacén para guardar archivos, sino una «fábrica» que produce tokens (la unidad básica generada por la IA).
Jensen Huang enfatizó:
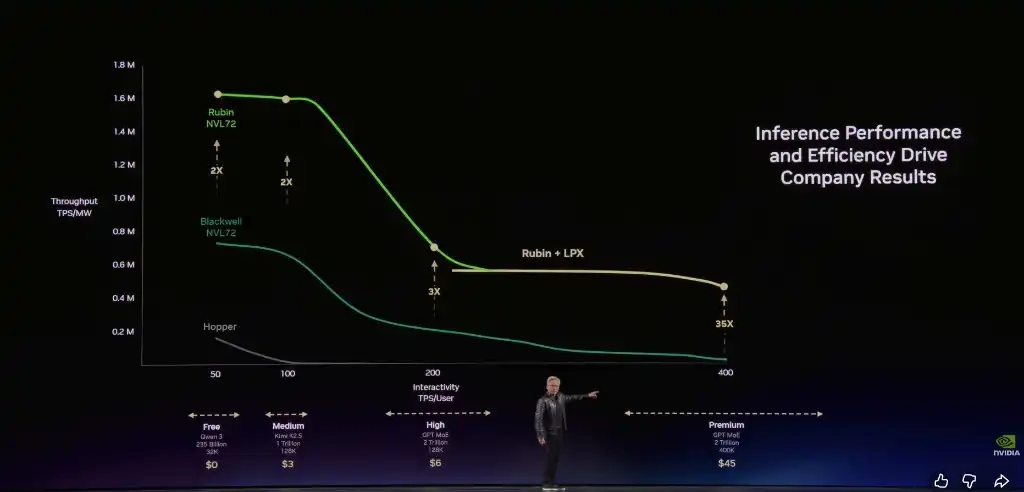
Por definición, todos los centros de datos y todas las fábricas están limitados por la energía. Una fábrica de 1 gigavatio (GW) nunca se convertirá en una de 2GW; es una ley de la física y de los átomos. Con un nivel de energía fijo, quien tenga el mayor rendimiento de tokens por vatio tendrá el menor costo de producción.
Jensen Huang dividió los futuros servicios de IA en cuatro niveles empresariales:
· Nivel gratuito (alto rendimiento, baja velocidad)
· Nivel medio (~$3 por millón de tokens)
· Nivel alto (~$6 por millón de tokens)
· Nivel de alta velocidad (~$45 por millón de tokens)
· Nivel de velocidad ultraalta (~$150 por millón de tokens)
Señaló que, a medida que los modelos crezcan y los contextos se alarguen, la IA será más inteligente, pero disminuirá la tasa de generación de tokens. Jensen Huang dijo:
En esta fábrica de tokens, tu rendimiento y velocidad de generación de tokens se traducirán directamente en tus ingresos precisos del próximo año.
Jensen Huang enfatizó que la arquitectura de NVIDIA permite a los clientes lograr un rendimiento extremadamente alto en el nivel gratuito y, al mismo tiempo, ofrecer un impresionante aumento de rendimiento de 35x en el nivel de inferencia de mayor valor.
Vera Rubin logra una aceleración de 350x en dos años y Groq cubre la brecha de la inferencia rápida
Ante esta limitación física, NVIDIA presenta su sistema de computación para IA más complejo hasta la fecha: Vera Rubin. Huang Renxun afirmó:
Cuando antes hablábamos de Hopper, levantaba un chip, que era lindo. Pero, cuando hablamos de Vera Rubin, todos piensan en el sistema completo. En este sistema con refrigeración líquida al 100% y que elimina por completo los cables tradicionales, los racks que antes tardaban dos días en instalarse ahora solo tardan dos horas.
Huang Renxun señaló que, gracias al codiseño extremo de hardware y software de principio a fin, Vera Rubin logró un impresionante salto de datos dentro del mismo centro de datos de 1GW:
En solo dos años, aumentamos la tasa de generación de tokens de 22M a 700M, lo que representa un crecimiento de 350x. En el mismo período, la Ley de Moore solo habría podido ofrecer una mejora aproximada de 1.5x.
Para resolver el cuello de botella del ancho de banda en condiciones de inferencia rápida (como 1000 tokens/segundo), NVIDIA ha propuesto una solución definitiva al integrar la empresa adquirida Groq: la inferencia con separación asimétrica.
Huang Renxun explicó:
Las características de estos dos procesadores son completamente distintas. El chip Groq tiene 500MB de SRAM, mientras que un solo chip Rubin tiene 288GB de memoria.
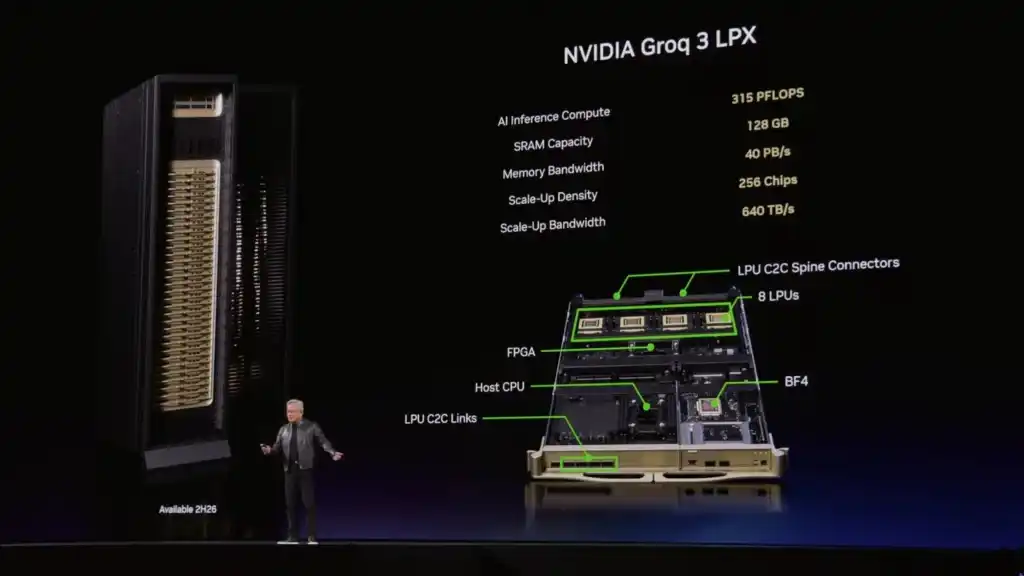
Huang Renxun señaló que NVIDIA, mediante el sistema de software Dynamo, asigna a Vera Rubin la etapa de «prellenado», que requiere una gran cantidad de computación y memoria, y a Groq la etapa de «decodificación», muy sensible a la latencia. Huang Renxun también ofreció recomendaciones para asignar la potencia de cálculo empresarial:
Si tu trabajo se centra principalmente en un alto rendimiento, usa 100% Vera Rubin; si tienes una cantidad considerable de necesidades de generación de tokens programática de alto valor, asigna 25% de la escala de tu centro de datos a Groq.
Se reveló que el chip Groq LP30, fabricado por Samsung, ya está en producción en masa y se espera que sus envíos comiencen en el tercer trimestre, mientras que el primer rack Vera Rubin ya está funcionando en Microsoft Azure Cloud.
Además, en cuanto a la tecnología de interconexión óptica, Huang Renxun presentó el primer switch Spectrum X del mundo con óptica coempaquetada (CPO) producido en masa, poniendo fin al debate del mercado sobre la ruta de «cobre a luz».
Necesitamos más capacidad de cables de cobre, más capacidad de chips ópticos y más capacidad de CPO.
Precio de --
Los agentes ponen fin al SaaS tradicional: «salario anual + tokens» se convierte en la norma de Silicon Valley
Además de las barreras de hardware, Huang Renxun dedicó mucho espacio a la revolución del software y los ecosistemas de IA, especialmente al auge de los agentes.
Describió el proyecto de código abierto OpenClaw como «el proyecto de código abierto más popular de la historia de la humanidad» y afirmó que superó los logros de Linux de los últimos 30 años en solo unas semanas. Huang Renxun declaró sin rodeos que OpenClaw es, en esencia, el «sistema operativo» de las computadoras con agentes.
Huang Renxun afirmó:
Todas las empresas de SaaS (software como servicio) se convertirán en empresas de AaaS (agentes como servicio). Sin duda, para implementar de forma segura estos agentes inteligentes con acceso a datos sensibles y capacidad para ejecutar código, NVIDIA lanzó el diseño de referencia empresarial NeMo Claw, que incorpora un motor de políticas y un enrutador de privacidad.
Para los profesionales comunes, esta transformación también está a su alcance. Huang Renxun describió cómo será el lugar de trabajo del futuro:
En el futuro, todos los ingenieros de nuestra empresa necesitarán un presupuesto anual de tokens.Su salario base podría ser de cientos de miles de dólares y, además, les asignaré aproximadamente la mitad de esa cantidad como presupuesto de tokens, para que puedan multiplicar su eficiencia por 10.Este ya es un nuevo incentivo de contratación en Silicon Valley: ¿cuántos tokens incluye tu oferta?
Al final de la presentación, Huang Renxun también adelantó la arquitectura de computación de próxima generación, Feynman, que permitirá por primera vez la expansión horizontal simultánea de cables de cobre y CPO. Aún más interesante, NVIDIA está desarrollando la computadora para centros de datos «Vera Rubin Space-1», que se desplegará en el espacio y abrirá por completo la posibilidad de extender la potencia de procesamiento de IA más allá de la Tierra.
A continuación, presentamos el texto completo del discurso de Huang Renxun en GTC 2026, traducido con la ayuda de una herramienta de IA:
Presentador: Demos la bienvenida al escenario a Huang Renxun, fundador y director ejecutivo de NVIDIA.
Huang Renxun, fundador y director ejecutivo: Bienvenidos a GTC. Quiero recordarles a todos que esta es una conferencia técnica. Me alegra mucho ver a tantas personas haciendo fila desde temprano para entrar y verlos aquí a todos.
En GTC nos enfocaremos en tres temas principales: tecnología, plataforma y ecosistema.
Actualmente, NVIDIA tiene tres plataformas principales: la plataforma CUDA-X, la plataforma de sistemas y la más reciente, la plataforma de fábricas de IA.
Antes de empezar, quiero agradecer a quienes presentaron los eventos previos: Sarah Guo, de Conviction; Alfred Lin, de Sequoia Capital (el primer inversionista de capital de riesgo de NVIDIA); y Gavin Baker, el primer inversionista institucional importante de NVIDIA. Estos tres tienen una profunda visión técnica y una gran influencia en todo el ecosistema tecnológico. Por supuesto, también quiero agradecer a todos los invitados especiales a quienes invité personalmente para que asistieran hoy. Gracias a este equipo de estrellas.
También quiero agradecer a todas las empresas presentes hoy. NVIDIA es una empresa de plataformas; tenemos tecnología, una plataforma y un rico ecosistema. Las empresas representadas hoy abarcan casi a todos los participantes de la industria de $100B, y 450 empresas patrocinan este evento. Muchas gracias a todas.
Esta conferencia incluye 1,000 sesiones técnicas y 2,000 ponentes, y cubre todos los niveles de la arquitectura de «stack completo» de IA: desde elementos fundamentales como terrenos, energía y centros de datos, hasta chips, plataformas, modelos y una variedad de aplicaciones que impulsan a toda la industria.
CUDA: dos décadas de legado técnico
Todo comenzó aquí. Este año se cumple el vigésimo aniversario de CUDA.
Durante dos décadas nos hemos dedicado al desarrollo de esta arquitectura. CUDA es una invención revolucionaria: la tecnología SIMT (un solo flujo de instrucciones, múltiples hilos) permite a los desarrolladores escribir programas con código escalar y ampliarlos a aplicaciones multihilo, con una complejidad de programación mucho menor que la de las arquitecturas SIMD anteriores. Hace poco añadimos la funcionalidad Tiles para ayudar a los desarrolladores a programar con más facilidad los núcleos tensoriales, cuya estructura de operaciones matemáticas es crucial para la IA actual. Actualmente, CUDA cuenta con miles de herramientas, compiladores, frameworks y bibliotecas, así como cientos de miles de proyectos de código abierto en la comunidad, y está profundamente integrado en todos los ecosistemas tecnológicos.
Este gráfico revela la lógica estratégica de 100% de NVIDIA, de la que hablo desde el primer día. El elemento más difícil y fundamental de alcanzar es la «base instalada» que aparece en la parte inferior del gráfico. Durante más de veinte años, hemos acumulado cientos de millones de GPU y sistemas de computación compatibles con CUDA en todo el mundo.
Nuestras GPU abarcan todas las plataformas de nube y prestan servicio a casi todos los fabricantes de computadoras y las industrias. La enorme base instalada de CUDA es la razón fundamental de este volante de crecimiento acelerado. La base instalada atrae a desarrolladores; los desarrolladores crean nuevos algoritmos e innovaciones; estas innovaciones impulsan nuevos mercados; los nuevos mercados forman nuevos ecosistemas y atraen a más empresas, lo que amplía la base instalada. Este volante sigue acelerándose.
La cantidad de descargas de las bibliotecas de NVIDIA crece a un ritmo impresionante, con una escala considerable y un impulso cada vez mayor. Este volante permite que nuestra plataforma de computación admita aplicaciones a gran escala y una corriente constante de nuevas innovaciones.
Más importante aún, también otorga a estas infraestructuras una vida útil extremadamente larga. La razón es clara: existe un amplio conjunto de aplicaciones que funcionan con NVIDIA CUDA, que abarca todas las etapas del ciclo de vida de la IA, diversas plataformas de procesamiento de datos y varios solucionadores de principios científicos. Por lo tanto, una vez instalada una GPU de NVIDIA, su utilidad real es muy alta. Esta es también la razón por la que han aumentado los precios en la nube de nuestras GPU con arquitectura Ampere, lanzadas hace seis años.
La razón fundamental de todo esto es: una enorme base instalada, un potente volante de crecimiento y un amplio ecosistema de desarrolladores. Cuando estos factores funcionan juntos, sumados a nuestras continuas actualizaciones de software, el costo de la computación sigue disminuyendo. A medida que la computación acelera y mejora significativamente el rendimiento de las aplicaciones, junto con nuestro mantenimiento e iteración de software a largo plazo, los usuarios no solo pueden experimentar un salto de rendimiento al principio, sino también disfrutar continuamente de la reducción de los costos de computación. Estamos dispuestos a brindar soporte a largo plazo para todas las GPU del mundo porque son totalmente compatibles a nivel de arquitectura.
Estamos dispuestos a hacerlo gracias a la enorme base instalada: cada vez que lanzamos una nueva optimización, puede beneficiar a millones de usuarios. Esta combinación dinámica permite que la arquitectura de NVIDIA amplíe continuamente su alcance, acelere su propio crecimiento, reduzca constantemente los costos de computación y, en última instancia, estimule un nuevo crecimiento. CUDA está en el centro de todo esto.
De GeForce a CUDA: 25 años de evolución
Y nuestro camino con CUDA comenzó en realidad hace veinticinco años.
GeForce: creo que muchos de ustedes crecieron con GeForce. GeForce es el proyecto de marketing más exitoso de NVIDIA. Empezamos a formar a nuestros futuros clientes cuando aún no podían comprar nuestros productos: sus padres fueron los primeros usuarios de NVIDIA y compraron nuestros productos año tras año, hasta que un día ustedes crecieron y se convirtieron en destacados informáticos, clientes reales y desarrolladores.
Esta es la base que GeForce sentó hace veinticinco años. Hace veinticinco años inventamos el shader programable, una invención que parecía obvia pero era profundamente importante y que hizo posible la programabilidad de los aceleradores y el primer acelerador programable del mundo, es decir, el shader de píxeles. Cinco años después creamos CUDA, una de nuestras inversiones más importantes. En ese momento, los recursos financieros de la empresa eran limitados, pero apostamos la mayor parte de las ganancias a este proyecto y nos comprometimos a llevar CUDA de GeForce a todas las computadoras. Mantuvimos esa determinación porque creíamos firmemente en su potencial. A pesar de las dificultades iniciales, la empresa mantuvo esa convicción durante 13 generaciones, a lo largo de veinte años, y hoy CUDA está en todas partes.
El shader de píxeles impulsó la revolución de GeForce. Y hace unos ocho años presentamos RTX: un replanteamiento integral de la arquitectura para la era moderna de los gráficos por computadora. GeForce llevó CUDA al mundo y, como resultado, permitió que investigadores como Alex Krizhevsky, Ilya Sutskever, Geoffrey Hinton, Andrew Ng y muchos otros descubrieran que la GPU podía ser una herramienta potente para acelerar el aprendizaje profundo, lo que desencadenó la explosión de la IA hace una década.
Hace diez años, decidimos combinar los shaders programables con dos nuevos conceptos: el primero era el trazado de rayos por hardware, que planteaba un desafío técnico; el otro era una idea visionaria para la época: hace aproximadamente una década, previmos que la IA transformaría fundamentalmente los gráficos por computadora. Así como GeForce llevó la IA al mundo, ahora la IA está transformando a su vez toda la implementación de los gráficos por computadora.
Hoy voy a mostrarles el futuro. Esta es nuestra tecnología gráfica de próxima generación, llamada Neural Rendering: la integración profunda de los gráficos 3D y la inteligencia artificial. Esto es DLSS 5, mírenlo.
Neural Rendering: la fusión de datos estructurados e IA generativa
¿No es increíble? Los gráficos por computadora han cobrado nueva vida.
¿Qué hicimos? Combinamos los gráficos 3D controlables (la base real del mundo virtual) con sus datos estructurados y los integramos con la IA generativa y el cálculo probabilístico. Uno es totalmente determinista y el otro, probabilístico pero muy realista. Combinamos estos dos conceptos para lograr un control preciso mediante datos estructurados y, al mismo tiempo, permitir la generación en tiempo real. Al final, el contenido es visualmente impresionante y completamente controlable.
El concepto de integrar información estructurada con IA generativa seguirá replicándose en una industria tras otra. Los datos estructurados son la piedra angular de una IA confiable.
Plataforma de aceleración para datos estructurados y no estructurados
Ahora voy a mostrarles un diagrama técnico de la arquitectura.
En cuanto a los datos estructurados, herramientas conocidas como SQL, Spark, Pandas y Velox, así como plataformas clave como Snowflake, Databricks, Amazon EMR, Azure Fabric, Google BigQuery y otras, trabajan con marcos de datos. Estos marcos funcionan como enormes hojas de cálculo, contienen toda la información del mundo empresarial y constituyen la fuente de verdad de la computación empresarial.
En la era de la IA, necesitamos que la IA trabaje con datos estructurados y alcance la máxima aceleración. Antes, acelerar el procesamiento de datos estructurados tenía como objetivo mejorar la eficiencia de las empresas. Sin embargo, en el futuro, la IA utilizará estos datos estructurados a velocidades muy superiores a las capacidades humanas, y los agentes de IA consultarán intensamente las bases de datos estructuradas.
En el ámbito de los datos no estructurados, las bases de datos vectoriales, los PDF, los videos, los audios y otros formatos constituyen la gran mayoría de los datos del mundo: alrededor de 90% de los datos generados cada año son no estructurados. En el pasado, estos datos apenas se aprovechaban: los leíamos, los almacenábamos en sistemas de archivos y eso era todo. No podíamos consultarlos y era difícil recuperarlos porque los datos no estructurados carecen de un método de indexación sencillo; es necesario entender su significado y contexto. Ahora la IA puede hacerlo: mediante tecnologías de percepción y comprensión multimodales, puede leer documentos PDF, entender su significado e integrarlos en una estructura más amplia que permita realizar búsquedas.
NVIDIA ha creado dos bibliotecas fundamentales para este propósito:
· cuDF: para acelerar el procesamiento de marcos de datos y datos estructurados
· cuVS: para el almacenamiento vectorial, los datos semánticos y el procesamiento de datos de IA no estructurados
Estas dos plataformas se convertirán en algunas de las plataformas fundamentales más importantes del futuro.
Hoy anunciamos alianzas con varias empresas. IBM, inventora del lenguaje SQL, utilizará cuDF para acelerar su plataforma WatsonX Data. Dell colaboró con nosotros para crear Dell AI Data Platform, que integra cuDF y cuVS y consigue mejoras significativas de rendimiento en proyectos reales de NTT Data. En Google Cloud, no solo aceleramos Vertex AI, sino también BigQuery, y gracias a nuestra colaboración con Snapchat redujimos sus costos de computación en casi 80%.
Los beneficios de la computación acelerada son tres: velocidad, escala y costo. Esto sigue la lógica de la Ley de Moore: lograr un salto de rendimiento mediante la computación acelerada y optimizar continuamente los algoritmos para que todos se beneficien de la reducción constante de los costos de computación.
NVIDIA ha creado una plataforma de computación acelerada que reúne numerosas bibliotecas: RTX, cuDF, cuVTS y otras. Estas bibliotecas están integradas en servicios de nube y sistemas OEM de todo el mundo, y llegan en conjunto a usuarios de todo el planeta.
Colaboración estrecha con proveedores de nube
Colaboración con los principales proveedores de nube
Google Cloud: Aceleramos Vertex AI y BigQuery, tenemos una integración profunda con JAX/XLA y ofrecemos un rendimiento destacado en PyTorch. NVIDIA es el único acelerador global que sobresale tanto en PyTorch como en JAX/XLA. Incorporamos al ecosistema de Google Cloud a clientes como Base10, CrowdStrike, Puma, Salesforce y otros.
AWS: Aceleramos EMR, SageMaker y Bedrock, con una integración profunda con AWS. Lo que más me entusiasma este año es que incorporamos OpenAI a AWS, lo que impulsará significativamente el crecimiento del consumo de nube de AWS y ayudará a OpenAI a ampliar sus implementaciones regionales y su capacidad de computación.
Microsoft Azure: La supercomputadora de NVIDIA de 100 PFLOPS es la primera que construimos y la primera que se implementó en Azure; sentó una base fundamental para colaborar con OpenAI. Aceleramos los servicios de nube e AI Foundry de Azure y colaboramos para ampliar la presencia regional de Azure y profundizar la cooperación en la búsqueda de Bing.
También cabe destacar nuestra capacidad de «computación confidencial», que garantiza que ni siquiera los operadores puedan ver los datos y modelos de los usuarios. Las GPU de NVIDIA están entre las primeras del mundo en admitir computación confidencial, lo que permite implementar de manera confidencial modelos de OpenAI y Anthropic en entornos de nube de todo el mundo. Por ejemplo, con Synopsys aceleramos todos sus flujos de trabajo de EDA y CAD y los implementamos en Microsoft Azure.
Oracle: Somos el primer cliente de IA de Oracle, y me enorgullece haber podido explicar por primera vez a Oracle el concepto de nube de IA. Desde entonces, ha crecido rápidamente, y también incorporamos a muchos socios, como Cohere, Fireworks y OpenAI, entre otros.
CoreWeave: La primera nube del mundo nativa de IA, creada para alojar GPU y ofrecer servicios de nube de IA, con una excelente cartera de clientes y un sólido impulso de crecimiento.
Palantir + Dell: Una colaboración entre las tres empresas creó una plataforma de IA completamente nueva basada en Palantir Ontology Platform y su plataforma de IA, que puede implementar IA en cualquier país y en cualquier entorno aislado de redes, de forma totalmente local. Abarca todo: desde el procesamiento de datos (vectorizados o estructurados) hasta la pila completa de aceleración de IA.
NVIDIA ha establecido esta asociación especial con proveedores de servicios de nube de todo el mundo: incorporamos clientes a la nube y creamos un ecosistema de beneficio mutuo.
Integración vertical, apertura horizontal: la estrategia central de NVIDIA
NVIDIA es la primera empresa del mundo integrada verticalmente y abierta horizontalmente.
La necesidad de este modelo es muy sencilla: la computación acelerada no es un problema de chips ni de sistemas; se expresa mejor como aceleración de aplicaciones. La CPU puede hacer que la computadora funcione más rápido en general, pero este camino ha llegado a un cuello de botella. En el futuro, solo mediante la aceleración específica para aplicaciones o dominios se podrán lograr mejoras continuas de rendimiento y reducciones de costos.
Por eso NVIDIA debe profundizar en una biblioteca tras otra, un ámbito tras otro y una industria vertical tras otra. Somos una empresa de computación integrada verticalmente; no tenemos otra opción. Debemos entender las aplicaciones, comprender los ámbitos, conocer a fondo los algoritmos y poder implementarlos en cualquier escenario: centros de datos, la nube, instalaciones locales, el borde e incluso sistemas robóticos.
Al mismo tiempo, NVIDIA mantiene su apertura horizontal y está dispuesta a integrar su tecnología en la plataforma de cualquier socio, para que el mundo disfrute de los beneficios de la computación acelerada.
La composición de los asistentes a esta GTC lo refleja plenamente. La industria de servicios financieros es la que tiene la mayor proporción de asistentes; esperamos que vengan desarrolladores, no traders. Nuestro ecosistema abarca toda la cadena de suministro, de principio a fin. Tanto para las empresas de 50, 70 o 150 años de antigüedad, el año pasado fue el mejor de su historia. Estamos en el punto de partida de algo muy, muy importante.
CUDA-X: motor de computación acelerada para todas las industrias
NVIDIA ha logrado avances profundos en distintos sectores:
Conducción autónoma: un impacto amplio y de gran alcance
Servicios financieros: la inversión cuantitativa está pasando de la ingeniería manual de características al aprendizaje profundo impulsado por supercomputadoras, lo que inaugura su «momento Transformer»
Atención médica: vive su propio «momento ChatGPT», que abarca el descubrimiento de fármacos asistido por IA, agentes de diagnóstico con IA, atención al cliente médica y más
Industria: se está desarrollando la mayor ola de construcción del mundo, con fábricas de IA, fábricas de chips y fábricas de centros de datos
Entretenimiento y videojuegos: las plataformas de IA en tiempo real permiten traducción, transmisiones en vivo, interacción en juegos y agentes de compras inteligentes
Robótica: tras más de una década de desarrollo, ya están listas tres arquitecturas de computación principales (computadora de entrenamiento, computadora de simulación y computadora de a bordo), y en esta exposición se presentan un total de 110 robots
Telecomunicaciones: una industria de aproximadamente $2B, donde las estaciones base evolucionarán de una función exclusiva de comunicación a una plataforma de infraestructura de IA. La plataforma relacionada se llama Aerial y colabora estrechamente con empresas como Nokia, T-Mobile y otras
En el centro de todos estos ámbitos está nuestra biblioteca CUDA-X, donde NVIDIA realmente opera como empresa de algoritmos. Estas bibliotecas son los activos más importantes de la empresa y permiten que la plataforma de computación aporte valor real a diversas industrias.
Una de las bibliotecas más importantes es cuDNN (CUDA Deep Neural Network Library), que revolucionó la inteligencia artificial y dio lugar a la explosión moderna de la IA.
(Reproducir video de demostración de CUDA-X)
Todo lo que acaban de ver era una simulación, incluidos los solucionadores basados en física, los modelos físicos de agentes de IA y los modelos de robots de IA física. Todo está simulado, sin animación manual ni vinculación de articulaciones. Esta es la competencia central de NVIDIA: abrir estas oportunidades mediante un conocimiento profundo de los algoritmos y su integración orgánica con la plataforma de computación.
Empresas nativas de IA y la nueva era de la computación
Acaban de ver gigantes de la industria como Walmart, L'Oréal, JPMorgan Chase, Roche y Toyota, entre muchos otros que definen la sociedad actual, así como una gran cantidad de empresas de las que nunca han oído hablar. Las llamamos empresas nativas de IA. La lista es enorme e incluye a OpenAI, Anthropic y numerosas empresas emergentes que prestan servicios a diversos sectores verticales.
En los últimos dos años, esta industria ha experimentado un crecimiento asombroso. El capital de riesgo destinado a startups alcanzó $150.000 M, la cifra más alta de la historia de la humanidad. Más importante aún, el tamaño de las inversiones individuales saltó por primera vez de millones a cientos de millones e incluso miles de millones de dólares.
Esto tiene una sola razón: por primera vez en la historia, todas las empresas de esta categoría necesitan una enorme cantidad de recursos de computación y una gran cantidad de tokens. Esta industria está creando y generando tokens, o añadiendo valor a los tokens de instituciones como Anthropic y OpenAI.
Así como las revoluciones de las PC, de Internet y de la nube móvil dieron origen a un conjunto de empresas pioneras, la revolución de las plataformas de computación de esta generación también hará surgir un grupo de empresas muy influyentes que se convertirán en una fuerza importante en el mundo del futuro.
Los tres avances históricos que impulsan todo esto
¿Qué ocurrió exactamente en los últimos dos años? Tres grandes acontecimientos.
Primero: ChatGPT, el inicio de la era de la IA generativa (desde finales de 2022 hasta 2023)
No solo puede percibir y entender, sino también generar contenido único. Mostré la fusión de la IA generativa y los gráficos por computadora. La IA generativa cambia fundamentalmente la naturaleza de la computación: esta pasa de basarse en la recuperación a basarse en la generación, lo que repercute significativamente en la arquitectura de computadoras, los métodos de implementación y su importancia general.
Segundo: la IA de razonamiento, representada por o1
La capacidad de razonamiento permite a la IA reflexionar, planificar y descomponer problemas por sí misma, dividiendo aquellos que no puede comprender directamente en pasos manejables. o1 hace que la IA generativa sea confiable y capaz de razonar a partir de información real. Como resultado, aumentó significativamente la cantidad de tokens de contexto de entrada y de razonamiento, lo que produjo un importante incremento de la carga de computación.
Tercero: Claude Code, el primer modelo de agente inteligente
Puede leer archivos, escribir código, compilar, probar, evaluar e iterar. Claude Code revolucionó la ingeniería de software: 100% de los ingenieros de NVIDIA usan uno o más de Claude Code, Codex y Cursor, y ningún ingeniero de software trabaja sin ayuda de la IA.
Este es un nuevo punto de inflexión: ya no le preguntas a la IA «qué, dónde, cómo», sino que le pides que «cree, ejecute y construya», que use herramientas de forma proactiva, lea archivos, desglose problemas y actúe. La IA pasó de la percepción a la generación, luego al razonamiento y ahora realmente está haciendo el trabajo.
En los últimos dos años, el volumen de computación necesario para el razonamiento aumentó unas 10,000 veces, y el uso creció cerca de 100 veces. Siempre he creído que, en los últimos dos años, la demanda de computación aumentó 1,000,000 de veces; esta es la percepción compartida por todos, OpenAI y Anthropic. Más computación genera más tokens, mayores ingresos y una IA más inteligente. Ya llegó el punto de inflexión del razonamiento.
La era de la infraestructura de IA de un billón de dólares
En esta misma época el año pasado, dije aquí que teníamos un alto grado de confianza en la demanda y los pedidos de compra de Blackwell y Rubin antes de 2026, por un total aproximado de $500.000 M.
Hoy, un año después, en GTC, estoy aquí para decirles: de cara a 2027, la cifra que veo es al menos $1B. Y estoy convencido de que la demanda real de computación será mucho mayor que esto.
2025: el año de la inferencia para NVIDIA
2025 es el año de la inferencia para NVIDIA. Nuestro objetivo es garantizar que, además del entrenamiento y el posentrenamiento, se mantenga la excelencia en cada etapa del ciclo de vida de la IA, para que la infraestructura financiada siga funcionando eficientemente, tenga una vida útil efectiva más larga y un menor costo unitario.
Al mismo tiempo, Anthropic y Meta se incorporaron oficialmente a la plataforma NVIDIA y, en conjunto, representan un tercio de la demanda mundial de computación de IA. Los modelos de código abierto se acercan a la frontera tecnológica y están en todas partes.
NVIDIA es actualmente la única plataforma global capaz de ejecutar todos los ámbitos de la IA —lenguaje, biología, gráficos por computadora, visión computacional, voz, proteínas y química, robótica, etc.— y todos los modelos de IA, en cualquier idioma, ya sea en el borde o en la nube. La arquitectura de NVIDIA es versátil para todos estos escenarios, lo que nos convierte en la plataforma de menor costo y mayor confiabilidad.
Actualmente, 60% del negocio de NVIDIA proviene de los cinco principales proveedores de nube a hiperescala del mundo, y el 40% restante se distribuye entre nubes regionales, nubes soberanas, empresas, industria, robótica, computación en el borde y otras áreas. La amplitud del alcance de la IA es, por sí misma, su resiliencia: sin duda estamos ante una nueva era de transformación de las plataformas de computación.
Grace Blackwell y NVLink 72: innovación audaz en arquitectura
Durante el auge de la arquitectura Hopper, decidimos rediseñar por completo el sistema, ampliar NVLink de 8 carriles a NVLink 72 y desglosar y reestructurar todo el sistema. Grace Blackwell NVLink 72 fue una gran apuesta tecnológica, no fue fácil para todos los socios, y les doy las gracias de corazón.
Al mismo tiempo, presentamos NVFP4: no es un FP4 común, sino un nuevo tipo de núcleo tensorial y unidad de computación. Hemos demostrado que NVFP4 puede realizar inferencia sin pérdida de precisión y, al mismo tiempo, ofrecer grandes mejoras de rendimiento y eficiencia. También es igualmente aplicable al entrenamiento.
Además, presentamos uno tras otro una serie de nuevos algoritmos, como Dynamo y TensorRT-LLM, e incluso invertimos miles de millones de dólares para construir una supercomputadora dedicada a optimizar kernels, llamada DGX Cloud.
Los resultados demuestran que nuestro rendimiento de inferencia es extraordinario. Los datos de Semi Analysis, la evaluación más completa del rendimiento de inferencia de IA hasta la fecha, muestran que NVIDIA está muy por delante tanto en vatios por token como en costo por token. Aunque la Ley de Moore quizá habría aportado una mejora de rendimiento de 1.5x al H200 original, nosotros logramos 35x. Dylan Patel, de Semi Analysis, incluso dijo: «Jensen ocultó el potencial; en realidad, es 50x». Tiene razón.
Cito aquí sus palabras: «Jensen ocultó el potencial».
El costo por token de NVIDIA es el más bajo del mundo y, actualmente, nadie puede igualarlo. La razón es el codiseño extremo.
Tomemos como ejemplo Fireworks. Antes de que NVIDIA actualizara toda su suite de software y algoritmos, su velocidad media era de unos 700 tokens por segundo; después de la actualización, llegó a casi 5,000 por segundo, un aumento aproximado de 7x. Ese es el poder del codiseño extremo.
Fábrica de IA: del centro de datos a la fábrica de tokens
Antes, el centro de datos era un lugar para almacenar archivos; ahora es una fábrica que produce tokens. En el futuro, todos los proveedores de nube y todas las empresas de IA operarán con la «eficiencia de fábrica de tokens» como indicador central.
Este es mi argumento principal:
· Eje vertical: rendimiento: número de tokens generados por segundo con un nivel de energía fijo
· Eje horizontal: velocidad de tokens: velocidad de respuesta de cada inferencia. Cuanto mayor sea la velocidad, más grandes podrán ser los modelos utilizables, más largo el contexto y más inteligente la IA
El token es la nueva materia prima. Cuando madure, se fijarán precios por niveles:
· Nivel gratuito (alto rendimiento, baja velocidad)
· Nivel medio (~$3 por millón de tokens)
· Nivel alto (~$6 por millón de tokens)
· Nivel de alta velocidad (~$45 por millón de tokens)
· Nivel de velocidad ultraalta (~$150 por millón de tokens)
Grace Blackwell multiplicó por 35 el rendimiento en el nivel de precio más alto frente a Hopper y presentó un nivel completamente nuevo. Si simplificamos la estimación de los modelos y asignamos 25% de la energía a cada uno de los cuatro niveles, Grace Blackwell puede generar 5x más ingresos que Hopper.
Vera Rubin: sistema de computación de IA de próxima generación
(Reproducir video de presentación del sistema Vera Rubin)
Vera Rubin es un sistema completo, optimizado de principio a fin y diseñado específicamente para cargas de trabajo agénticas:
· Núcleo de computación para modelos grandes de lenguaje: clúster de GPU NVLink 72, que se encarga del prellenado y la caché KV
· CPU Vera completamente nueva: diseñada para un rendimiento monohilo extremadamente alto, con memoria LPDDR5 y excelente eficiencia energética. Es la única CPU de centro de datos del mundo que utiliza LPDDR5 y es adecuada para invocar herramientas de agentes de IA
· Sistema de almacenamiento: BlueField 4 + CX 9, una nueva plataforma de almacenamiento para la era de la IA, con 100% de la industria mundial del almacenamiento incorporada al switch CPO Spectrum X: el primer switch Ethernet óptico con óptica coempaquetada del mundo, actualmente en plena producción
· Rack Kyber: un nuevo sistema de racks que admite 144 GPU para formar un único dominio NVLink, con computación frontal y conmutación NVLink posterior, que crea una computadora gigante
· Rubin Ultra: nodo de supercomputadora de próxima generación, con un diseño de inserción vertical que, combinado con el rack Kyber, admite una interconexión NVLink de mayor escala
Vera Rubin ahora cuenta con refrigeración líquida al 100%, lo que reduce el tiempo de instalación de dos días a dos horas. Utiliza refrigeración con agua tibia a 45°C para reducir significativamente la presión de refrigeración de los centros de datos. Satya (Nadella) confirmó en una publicación que el primer rack Vera Rubin ya está operativo en Microsoft Azure, algo que me entusiasma profundamente.
Integración de Groq: extensión máxima del rendimiento de inferencia
Adquirimos el equipo de Groq y obtuvimos la licencia de su tecnología. Groq es un procesador de flujo de datos determinista que utiliza compilación estática y planificación del compilador, cuenta con una gran cantidad de SRAM y está optimizado para inferir una sola carga de trabajo, con latencia extremadamente baja y una alta velocidad de generación de tokens.
Sin embargo, Groq tiene una memoria integrada limitada (500MB de SRAM en el chip), por lo que le resulta difícil manejar por sí solo los parámetros de los modelos grandes y la caché KV, lo que limita su aplicación a gran escala.
La solución es Dynamo, un software de planificación de inferencias. Con Dynamo estamos desagregando el pipeline de inferencia:
· Prellenado y decodificación del mecanismo de atención: se realizan en Vera Rubin (requieren una potencia de cálculo considerable y almacenamiento de caché KV)
· Decodificación de la red feed-forward: la parte de generación de tokens se realiza en Groq (requiere un ancho de banda alto y baja latencia)
Ambos están estrechamente conectados por Ethernet y reducen la latencia aproximadamente a la mitad mediante un modo especial. Bajo la planificación unificada de Dynamo, el «sistema operativo de las fábricas de IA», el rendimiento general aumenta 35 veces y abre un nuevo nivel de rendimiento de inferencia que antes NVLink 72 no podía alcanzar.
Recomendación para combinar Groq y Vera Rubin:
Si la carga de trabajo exige mucho rendimiento, usa 100% Vera Rubin; si una gran parte de la carga de trabajo consiste en generar tokens de alto valor, como en la generación de código,
incorpora Groq, con una proporción recomendada de aproximadamente 25% Groq + 75% Vera Rubin. Groq LP30 es fabricado por Samsung, actualmente está en producción y se espera que sus envíos comiencen en el tercer trimestre. Gracias a Samsung por su plena colaboración.
Un salto histórico en el rendimiento de inferencia
Cuantifiquemos los avances tecnológicos anteriores: en un período de 2 años, la tasa de generación de tokens de una fábrica de IA de 1 gigavatio aumentará de 22M tokens/segundo a 7.000 M tokens/segundo, una mejora de 350x. Este es el poder del codiseño extremo.
Hoja de ruta tecnológica
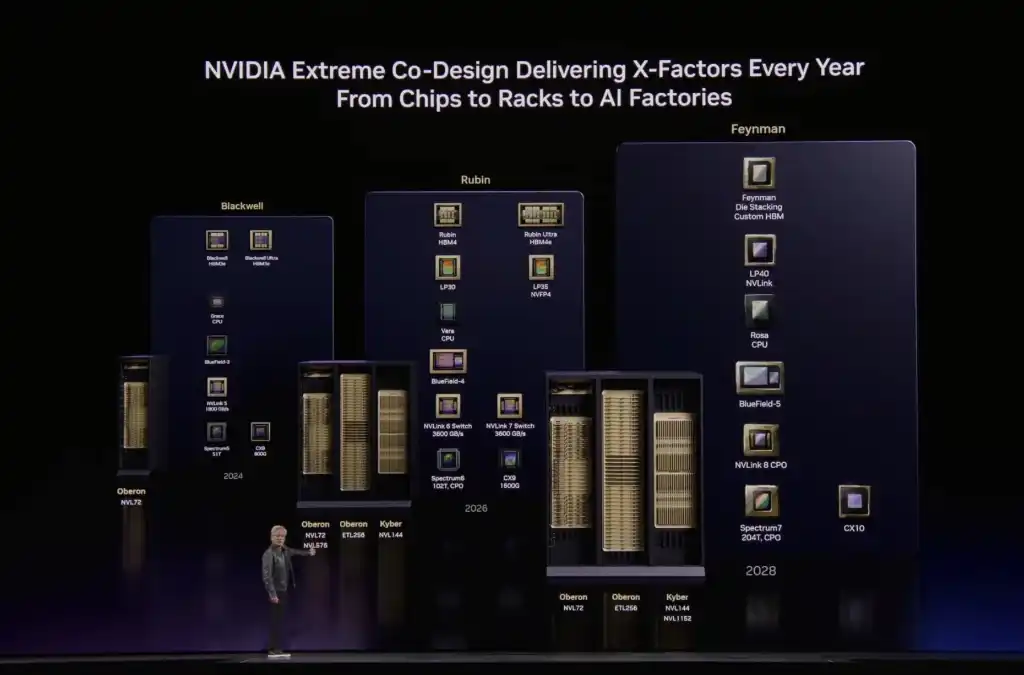
· Blackwell: actualmente en producción; sistema de rack estándar Oberon, cableado de cobre ampliado a NVLink 72, con opción de extensión óptica a NVLink 576
· Vera Rubin (actual): rack Kyber, NVLink 144 (cableado de cobre); rack Oberon, óptica NVLink 72 +, ampliada a NVLink 576; Spectrum 6, el primer switch CPO del mundo
· Vera Rubin Ultra (próxima): GPU Rubin Ultra de próxima generación y chip LP35 (el primero en integrar NVFP4), con un aumento adicional de varias veces en el rendimiento
· Feynman (próxima generación): GPU completamente nueva, chip LP40 (desarrollado conjuntamente por NVIDIA y el equipo de Groq, con NVFP4 integrado); CPU completamente nueva, Rosa (Rosalyn); BlueField 5; CX 10; rack Kyber compatible con expansiones tanto de cableado de cobre como de CPO
Hoja de ruta clara: las rutas de expansión de cobre, expansión óptica a escala vertical y expansión óptica a escala horizontal avanzan en paralelo, por lo que todos los socios deben seguir ampliando la producción de cobre, fibra y CPO.
NVIDIA DSX: plataforma de gemelos digitales para fábricas de IA
Las fábricas de IA son cada vez más complejas, pero los distintos proveedores de tecnología que las componen nunca han colaborado durante la fase de diseño, sino hasta que se «encuentran» en el centro de datos. Esto claramente no es suficiente.
Para solucionarlo, creamos Omniverse y la plataforma NVIDIA DSX, construida sobre esta, un entorno para que todos los socios diseñen y operen colectivamente fábricas de IA a escala de exaescala en un mundo virtual. DSX ofrece:
· Sistemas de simulación mecánica, térmica, eléctrica y de redes a nivel de rack
· Conexión a la red eléctrica para una programación colaborativa que ahorra energía
· Optimización dinámica de energía y refrigeración dentro de los centros de datos, basada en Max-Q
Según una estimación conservadora, este sistema puede mejorar aproximadamente 2 veces la eficiencia en el uso de energía, una ganancia significativa a la escala de la que hablamos. Omniverse parte del gemelo digital de la Tierra y aloja gemelos digitales de distintas escalas. Estamos trabajando con socios de todo el mundo para construir conjuntamente la computadora más grande de la historia de la humanidad.
Además, NVIDIA se está aventurando en el espacio. El chip Thor recibió la certificación de resistencia a la radiación y ya funciona en satélites. Colaboramos con socios para desarrollar Vera Rubin Space-1, destinada a construir centros de datos espaciales. En el espacio solo es posible la refrigeración por radiación, lo que convierte la gestión térmica en un desafío central. Estamos reuniendo a ingenieros de primer nivel para resolverlo.
OpenClaw: sistema operativo para la era de los agentes
Peter Steinberger desarrolló un software llamado OpenClaw. Es el proyecto de código abierto más popular de la historia de la humanidad y superó los logros de Linux de treinta años en solo unas semanas.
OpenClaw es, en esencia, un sistema agéntico que puede:
· Administrar recursos y acceder a herramientas, sistemas de archivos y modelos grandes de lenguaje
· Ejecutar programación de tareas y tareas programadas
· Desglosar problemas paso a paso e invocar subagentes
· Admitir entradas y salidas en cualquier modalidad (voz, video, texto, correo electrónico, etc.)
En el lenguaje de los sistemas operativos, realmente es un sistema operativo: un sistema operativo para la computadora agente. Si Windows hizo posible la computación personal, OpenClaw hace posible la agencia personal.
Todas las empresas necesitarán desarrollar su propia estrategia para OpenClaw, así como todos necesitamos estrategias para Linux, HTML y Kubernetes.
Transformación integral de la TI empresarial
La TI empresarial antes de OpenClaw: Los datos y archivos ingresan al sistema, circulan por herramientas y flujos de trabajo y, finalmente, se convierten en herramientas para uso humano. Las empresas de software crean herramientas, mientras que los integradores globales de sistemas (GSI) y las firmas de consultoría ayudan a las empresas a utilizarlas.
La TI empresarial después de OpenClaw: Todas las empresas de SaaS se transformarán en empresas de AaaS (Agentic as a Service, agentes como servicio): ya no solo ofrecerán herramientas, sino también agentes de IA especializados en ámbitos específicos.
Pero hay un desafío clave: Los agentes internos de una empresa pueden acceder a datos confidenciales, ejecutar código y comunicarse con el exterior. En un entorno empresarial, esto debe controlarse rigurosamente.
Para lograrlo, nos asociamos con Peter para incorporar seguridad en la versión de nivel empresarial y presentamos lo siguiente:
· NeMo Claw (diseño de referencia): Un marco de referencia de nivel empresarial basado en OpenClaw, que integra el conjunto completo de herramientas de agentes de IA de NVIDIA
· Open Shield (capa de seguridad): Integrado en OpenClaw, ofrece un motor de políticas, un perímetro de red y enrutamiento de privacidad para garantizar la seguridad de los datos empresariales
· NeMo Cloud: Disponible para descargar e interoperable con todos los motores de políticas empresariales de SaaS
Este es el renacimiento de la TI empresarial, una industria que originalmente tenía un valor de 2B dólares y que crecerá hasta alcanzar decenas de billones de dólares, pasando de ofrecer herramientas a ofrecer servicios especializados de agentes de IA.
Puedo imaginarlo perfectamente: En el futuro, cada ingeniero de una empresa tendrá un presupuesto anual de tokens. Su salario podría ser de cientos de miles de dólares, y yo le asignaré tokens adicionales equivalentes a la mitad de su salario, lo que multiplicará por diez su productividad. «¿Cuántos tokens incluye la oferta de trabajo?» se ha convertido en un nuevo tema candente de reclutamiento en Silicon Valley.
En el futuro, todas las empresas serán tanto usuarias de tokens (para que los usen sus ingenieros) como productoras de tokens (para ofrecer servicios a sus clientes). No se puede subestimar la importancia de OpenClaw: es tan importante como HTML y Linux.
Iniciativa de modelos abiertos de NVIDIA
Para Custom Claws, ofrecemos los modelos de vanguardia desarrollados internamente por NVIDIA:
Entre los modelos se encuentran Nemotron, para el ámbito del lenguaje; Cosmos, como modelo fundacional del mundo; GROOT, para robótica humanoide de propósito general; Alpamayo, para conducción autónoma; BioNeMo, para biología digital; y Phys-AIAI, para física.
Estamos a la vanguardia en cada ámbito y nos comprometemos a seguir innovando: Nemotron 4 sucederá a Nemotron 3, Cosmos 2 sucederá a Cosmos 1 y Groq también avanzará a su segunda generación.
Nemotron 3 está entre los tres mejores modelos del mundo en OpenClaw y se encuentra a la vanguardia. Nemotron 3 Ultra será el modelo fundacional más potente de la historia y ayudará a los países a desarrollar una IA soberana.
Hoy anunciamos la creación de Nemotron Alliance, que invertirá miles de millones de dólares para impulsar la investigación de modelos fundacionales de IA. Entre los miembros de la alianza están BlackForest Labs, Cursor, LangChain, Mistral, Perplexity, Reflection, Sarvam (India), Thinking Machines (el laboratorio de Mira Murati), entre otros.
Una tras otra, las empresas de software empresarial se están sumando e integrando en sus productos el diseño de referencia NeMo Claw y el kit de herramientas de IA para agentes inteligentes de NVIDIA.
IA física y robótica
Un avatar digital actúa en el mundo digital —escribe código y analiza datos—, mientras que una IA física es un agente con cuerpo, es decir, un robot.
En esta GTC debutaron un total de 110 robots, que representaban a casi todas las empresas de investigación y desarrollo de robótica del mundo. NVIDIA proporcionó tres computadoras (una computadora de entrenamiento, una computadora de simulación y una computadora integrada), además de una pila de software completa y modelos de IA.
En el ámbito de la conducción autónoma, ha llegado la era del «momento ChatGPT» de la conducción autónoma. Hoy anunciamos que cuatro nuevos socios se incorporan a la plataforma NVIDIA RoboTaxi Ready: BYD, Hyundai, Nissan y Geely, con una producción anual combinada de 18M vehículos. Junto con los socios anteriores —Mercedes-Benz, Toyota y GM—, la lista se fortalece aún más. También anunciamos una importante alianza con Uber para desplegar e integrar vehículos RoboTaxi Ready en varias ciudades.
En el sector de la robótica industrial, numerosas empresas de robótica, como ABB, Universal Robotics y KUKA, se están asociando con nosotros para combinar modelos de IA física con sistemas de simulación e impulsar la implementación de robots en líneas de producción de todo el mundo.
En el sector de las telecomunicaciones también participan Caterpillar y T-Mobile. En el futuro, las estaciones base inalámbricas dejarán de ser simples nodos de comunicación y se convertirán en una NVIDIA Aerial AI RAN: una plataforma inteligente de computación en el borde capaz de detectar el tráfico en tiempo real, ajustar la formación de haces y lograr mejoras en el ahorro de energía y la eficiencia.
Segmento especial: debut del robot Olaf
(Reproducir el video de demostración del robot Olaf de Disney)
Jensen Huang: ¡Llegó el muñeco de nieve! ¡Newton funciona bien! ¡Omniverse también funciona bien! Olaf, ¿cómo estás?
Olaf: Me alegra mucho verte.
Jensen Huang: ¡Sí, porque te di una computadora: una Jetson!
Olaf: ¿Qué es eso?
Jensen Huang: Está dentro de tu barriga.
Olaf: Qué mágico.
Jensen Huang: Aprendiste a caminar en Omniverse.
Olaf: Me gusta caminar. Es mucho mejor que ir montado en un reno domesticado y mirar el hermoso cielo.
Richard Huang: Esto es precisamente gracias a la simulación física, que se ejecuta en el solucionador Newton basado en NVIDIA Warp que desarrollamos junto con Disney y DeepMind. Así puedes adaptarte al mundo físico real.
Olaf: Justo iba a decir eso.
Richard Huang: Ahí es donde se nota tu inteligencia. Soy un muñeco de nieve, no una bola de nieve.
Richard Huang: ¿Te lo imaginas? En los parques de Disney del futuro, todos estos personajes robóticos paseando libremente por el parque. Pero, para ser sincero, pensé que serías más alto. Nunca había visto un muñeco de nieve tan bajito.
Olaf: (No confirma ni desmiente)
Richard Huang: ¿Me ayudarás a cerrar la presentación de hoy?
Olaf: ¡Por supuesto!
Resumen de la presentación principal
Richard Huang: Hoy exploramos juntos los siguientes temas clave:
1. La llegada del punto de inflexión de la inferencia: La inferencia se ha convertido en la carga de trabajo más importante de la IA; los tokens son el nuevo producto básico y el rendimiento de la inferencia determina directamente los ingresos.
2. La era de las fábricas de IA: Los centros de datos han evolucionado de instalaciones para almacenar archivos a fábricas que producen tokens y, en el futuro, todas las empresas medirán su competitividad según la «eficiencia de sus fábricas de IA».
3. La revolución de los agentes inteligentes de OpenClaw: OpenClaw ha dado paso a la era de la computación con agentes inteligentes. La TI empresarial está pasando de la era de las herramientas a la de los agentes inteligentes, y todas las empresas deberán diseñar una estrategia para OpenClaw.
4. IA física y robótica: La inteligencia incorporada está creciendo a gran escala, y la conducción autónoma, los robots industriales y los robots humanoides están definiendo conjuntamente la próxima gran oportunidad para la IA física.
¡Muchas gracias a todos y feliz GTC!
Este contenido se ofrece únicamente con fines informativos generales y no constituye asesoramiento financiero, de inversión, legal ni fiscal. Cualquier evento, recompensa, promoción en línea o información relacionada que se mencione en el presente documento no debe considerarse como una recomendación, solicitud o invitación a comprar, vender, tradear o de negociar de otra manera con cualquier criptoactivo. Los criptoactivos son sumamente volátiles y pueden provocar pérdidas. La disponibilidad de los servicios, productos y eventos relacionados de WEEX puede variar según la región. Tienes la responsabilidad de asegurarte de que tu participación esté de acuerdo con las leyes y regulaciones locales vigentes.
También te puede interesar

¿Cómo se convierte Hook en el "cerebro" del pool de transacciones con el comercio programable?

Meta lanza el "modelo de código abierto más potente de EE. UU."

Meta lanza el modelo de IA de pesos abiertos Muse Spark Open

Spark reporta más de 4 millones de dólares en retorno neto de acuerdos en el tercer trimestre, con un volumen de transacciones superior a 14 mil millones de dólares en el primer mes

Meta lanza la serie de modelos Muse Wonder, afirmando que el rendimiento en tareas de agentes inteligentes es líder
Financiación de capital de riesgo en criptomonedas: Spiko y Nous Research recaudan $90 millones cada uno

Breez Informa un Aumento de 14 Veces en la Demanda de Integración de Bitcoin
Las acciones de EE. UU. pueden ser utilizadas como garantía, pero el ciclo de préstamos en cadena aún necesita algunos eslabones

Informe matutino de Wall Street: El mercado alcista de IA enfrenta el juicio de las tasas de interés, los fondos comienzan a trasladarse a activos defensivos, los bonos a 30 años se convierten en la próxima prueba

Lightspark lanza el prototipo dotMoney, que permite enviar fondos de prueba a través de enlaces y archivos .money

Google lanza Playground para generar juegos jugables

Spark lidera una inversión de 2.4 millones de dólares, Antseed lanza una red de inferencia de IA

La oferta de Ripple RLUSD aumentó en 765 millones de dólares en el tercer trimestre

RWA Semanal: El gobierno de la Región Administrativa Especial de Hong Kong introduce depósitos tokenizados en dólares de Hong Kong; OUSD, la stablecoin en dólares liderada por Stripe, se lanza oficialmente

¿La Fundación Compound "se aferra a su auto-robo"?

La Musa de Meta: Una versión ligeramente más inteligente de 'IA pidiendo café'

El Santo Grial de DeFi en mi corazón

Blink Wallet Detiene Servicios Tras Compromiso de Cuentas Custodiales

Las acciones de AMD suben por tercera sesión consecutiva: el CTO afirma que la demanda de IA no muestra señales de desaceleración
AMD recuperó por completo el lunes la caída de 5.6% provocada por el temor a la IA y cerró la semana con un alza de 8%. Su CTO afirmó que la demanda de IA no muestra señales de desaceleración, respaldada por un crecimiento de 107% en centros de datos.
El ciclo de lanzamiento de modelos de IA entre China y EE. UU. se reduce a 44 días
Chamath afirma que el modelo de pesos de código abierto está a unos cuatro meses del mejor modelo cerrado
Galaxy lanza 2 bóvedas de stablecoin en Kamino

Crusoe completa una ronda de financiación Serie F de 3.9 mil millones de dólares, alcanzando una valoración de 30.9 mil millones de dólares

BitBox añade una billetera Lightning sin una nueva frase de respaldo

¿Puede SKY llegar a $0.10 en 2026? Standard Chartered se muestra optimista

Treehouse busca expandir el mercado de préstamos tETH a Compound V3
Bitget UEX Diario|El petróleo Brent regresa a 107 dólares; se acerca la reunión de la Reserva Federal; Nvidia negocia invertir hasta 10 mil millones de dólares en la salida a bolsa de Anthropic (14 de septiembre de 2026)
Uniswap amplía su liderazgo en DEX al superar los $70 mil millones en volumen

JPMorgan es optimista sobre Meta: Muse, API de modelos y suscripciones respaldan un precio objetivo de 820 dólares

¿Es ahora una buena oportunidad de compra mientras no entremos en un ciclo de aumento de tasas?
¿Cómo se convierte Hook en el "cerebro" del pool de transacciones con el comercio programable?
Meta lanza el "modelo de código abierto más potente de EE. UU."
Meta lanza el modelo de IA de pesos abiertos Muse Spark Open
Spark reporta más de 4 millones de dólares en retorno neto de acuerdos en el tercer trimestre, con un volumen de transacciones superior a 14 mil millones de dólares en el primer mes
Meta lanza la serie de modelos Muse Wonder, afirmando que el rendimiento en tareas de agentes inteligentes es líder
Financiación de capital de riesgo en criptomonedas: Spiko y Nous Research recaudan $90 millones cada uno
Contenido
Últimos artículos


Últimos listados de monedas en WEEX


