
پس از دو حادثه در یک هفته؛ نگاهی دوباره به صحبتهای همبنیانگذاران Anthropic دربارهٔ «ایمنی» در یک سال پیش

 امتیازدهی ما در گوگل


عنوان اصلی ویدئو: ساخت Anthropic | گفتوگویی با همبنیانگذاران ما
منبع اصلی ویدئو: Anthropic
ترجمهٔ متن اصلی: Deep Tide TechFlow
خلاصهٔ نکات کلیدی
Anthropic در هفتهٔ گذشته با دو حادثهٔ پیاپی روبهرو شد:
نخست، بهدلیل پیکربندی اشتباه CMS، نزدیک به 3000 فایل داخلی بهصورت عمومی افشا شد. پس از آن، Claude Code v2.1.88 هنگام انتشار در npm یک سورسمپ 59.8MB همراه داشت که باعث افشای 510,000 خط کد منبع شد.
برای شرکتی که «امنیت» را در DNA خود جای داده، تجربهٔ شکستهای عملیاتی پیاپی، نهایت طعنهآمیز بودن ماجراست.
پیش از آنکه برای تمسخر عجله کنیم، شاید بد نباشد به گفتوگوی داخلی هفت همبنیانگذار Anthropic در بیش از یک سال پیش بازگردیم. این پادکست در 12/2024 ضبط شد و این هفت نفر دربارهٔ چگونگی تأسیس شرکت، تدوین RSP (سیاست مقیاسپذیری مسئولانه)، دلیل اینکه نباید واژهٔ «امنیت» را سرسری به کار برد، و نقلقولی از مدیرعامل، Dario، که بارها به آن اشاره شده، صحبت کردند:
«اگر آژیر آتشنشانی یک ساختمان هر هفته به صدا دربیاید، آن ساختمان در واقع بسیار ناایمن است.»
شنیدن این جمله در حال حاضر، قطعاً حس متفاوتی دارد.
معرفی کوتاه هفت همبنیانگذار
Dario Amodei | مدیرعامل؛ معاون پیشین پژوهش در OpenAI با پیشینهٔ علوم اعصاب و تصمیمگیرندهٔ نهایی دربارهٔ نقشهٔ راه راهبردی و امنیتی Anthropic. او در این گفتوگو بیش از همه صحبت کرد.
Daniela Amodei | رئیس شرکت و خواهر Dario. پیشتر پنج سال و نیم در Stripe فعالیت کرد و سرپرستی تیم اعتماد و ایمنی را بر عهده داشت؛ همچنین در بخشهای غیرانتفاعی و توسعهٔ بینالمللی تجربه داشت. او عمدتاً بر ساختار سازمانی و ارتباطات بیرونی Anthropic نظارت میکند.
Jared Kaplan | استاد فیزیکی که به پژوهشگر هوش مصنوعی تبدیل شد و یکی از نویسندگان اصلی قوانین مقیاسپذیری است. او اغلب دیدگاهی بیرونی ارائه میدهد و میگوید در ابتدا به این دلیل سراغ هوش مصنوعی رفت که «از فیزیک خسته شده بود».
Chris Olah | چهرهای برجسته در پژوهش تفسیرپذیری؛ در 19سالگی به جامعهٔ هوش مصنوعی منطقهٔ خلیج سانفرانسیسکو پیوست و در Google Brain و OpenAI فعالیت کرد. آرمانگراترین متخصص فناوری در Anthropic.
Tom Brown | نویسندهٔ اول مقالهٔ GPT-3 که اکنون بر منابع محاسباتی Anthropic نظارت دارد. او با تمرکز بر مهندسی و زیرساخت، در پادکستها از تغییر دیدگاهش گفته است؛ از زمانی که «چندان باور نداشت هوش مصنوعی با این سرعت پیشرفت کند» تا وقتی نظرش عوض شد.
Jack Clark | روزنامهنگار پیشین حوزهٔ فناوری در Bloomberg که اکنون مدیر سیاستگذاری و امور عمومی Anthropic است. او در این گفتوگو مجری بود و معرفیها و پرسشهای تکمیلی را بر عهده داشت.
Sam McCandlish | همبنیانگذار بخش پژوهش؛ کمترین زمان را به صحبت اختصاص داد، اما اغلب با یک جمله نکتهٔ اصلی را بیان میکرد و نقش «ضربهٔ نهایی» را داشت.
خلاصهٔ نکات مهم
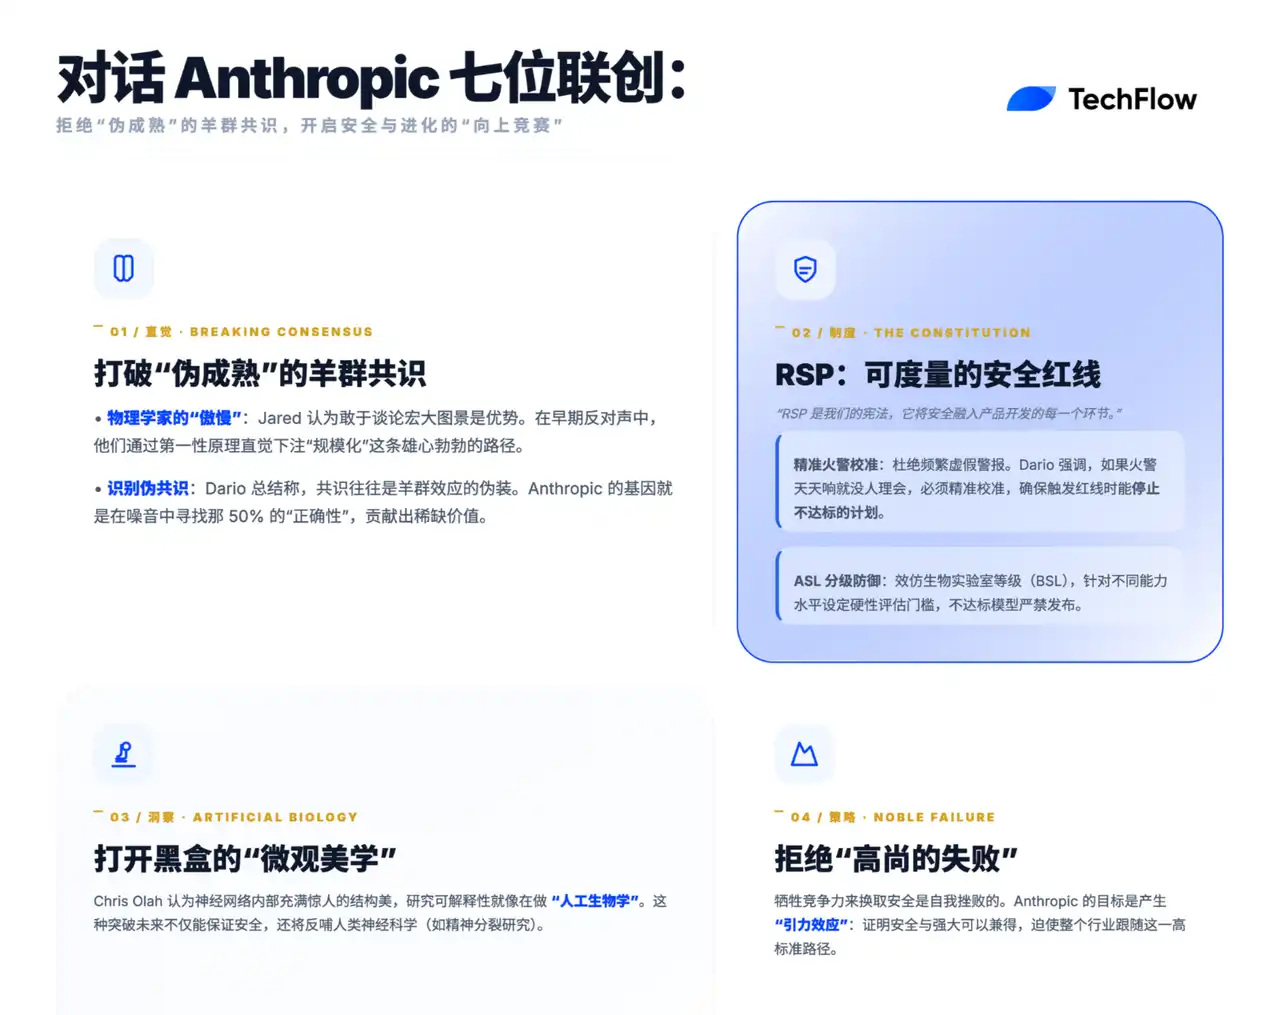
چرا سراغ هوش مصنوعی رفتند: از خستگی از فیزیک تا «دیدن شواهد کافی برای باور کردن»
Jared Kaplan: «مدت زیادی فیزیک کار میکردم و کمی خسته شده بودم. دلم میخواست با دوستان بیشتری کار کنم، برای همین به هوش مصنوعی روی آوردم.»
Dario Amodei: «فکر نمیکنم صریحاً قانعت کرده باشم. فقط مدام نتایج مدلهای هوش مصنوعی را به تو نشان میدادم. بالاخره بعد از اینکه بهاندازهٔ کافی نشان دادم، گفتی: “هوم، به نظر درست میآید.”
شرطبندی برخلاف جریان غالب: بخش زیادی از اجماع، ذهنیت گلهای است که خود را در لباس بلوغ پنهان میکند
Jared Kaplan: «بسیاری از پژوهشگران هوش مصنوعی از زمستان هوش مصنوعی زخم عمیقی برداشتهاند؛ انگار بلندپروازی مجاز نیست.»
Dario Amodei: «عمیقترین درسی که در دههٔ گذشته گرفتهام این است که بخش زیادی از اجماعِ مبتنی بر “همه میدانند”، در واقع ذهنیت گلهایای است که خود را در لباس بلوغ پنهان میکند. وقتی چند بار شاهد تغییر ناگهانی اجماع باشید، میگویید: نه، ما روی این موضوع شرط میبندیم. حتی اگر فقط %50 درست بگویید، چیزی به دانش دیگران اضافه میکنید که پیشتر ارائه نشده است.»
ایمنی و مقیاسپذیری به هم گره خوردهاند
Dario Amodei: «یکی از انگیزههای افزایش مقیاس مدل در آن زمان این بود که مدل باید آنقدر هوشمند میشد که RLHF بتواند کار کند. هنوز هم به این موضوع باور داریم: ایمنی و مقیاسپذیری به هم گره خوردهاند.»
RSP، سیاست مقیاسپذیری مسئولانه، «قانون اساسی» Anthropic است
Tom Brown: «برای Anthropic، RSP مثل قانون اساسی ماست. سندی بنیادی و راهنماست؛ به همین دلیل حاضریم زمان و تلاش زیادی صرف کنیم و بارها آن را اصلاح کنیم.»
Dario Amodei: «RSP مانع پیشرفت برنامههایی میشود که معیارهای ایمنی را برآورده نمیکنند. ما فقط شعار نمیدهیم؛ واقعاً ایمنی را در همهٔ ابعاد ادغام میکنیم.»
وقتی آژیر آتشنشانی بیش از حد به صدا دربیاید، هنگام آتشسوزی واقعی کسی فرار نمیکند
Daniela Amodei: «نمیتوانیم برای هدایت مسیر پیشرفت، بیمحابا از واژهٔ “ایمنی” استفاده کنیم. هدف واقعی ما این است که برای همه روشن کنیم منظورمان از ایمنی چیست.»
Dario Amodei: «چیزی که واقعاً ایمنی را تضعیف میکند، اغلب همان “مانورهای ایمنی” مکرر است. اگر آژیر آتشنشانی ساختمانی هر هفته به صدا دربیاید، آن ساختمان در واقع بسیار ناایمن است.»
دام «شکستِ نجیبانه»
Chris Olah: «این دیدگاه وجود دارد که اخلاقیترین کار، قربانی کردن هدفهای دیگر بهخاطر ایمنی است تا پاکی نیت خود را در راه این هدف نشان دهیم. اما این رویکرد در عمل نتیجهٔ معکوس میدهد، چون باعث میشود تصمیمگیری به دست کسانی بیفتد که برای ایمنی ارزشی قائل نیستند.»
تعهد همبنیانگذاران به اهدای %80 درآمدشان
Tom Brown: «همهٔ ما متعهد شدهایم %80 از درآمدمان را به هدفهایی اهدا کنیم که به توسعهٔ اجتماعی کمک میکنند؛ چیزی که همه با تمام وجود از آن حمایت میکنند.»
هیچکس نمیخواست شرکتی تأسیس کند، اما احساس میکرد باید این کار را انجام دهد
Sam McCandlish: «در ابتدا هیچکدام از ما واقعاً نمیخواستیم شرکتی تأسیس کنیم. فقط احساس میکردیم وظیفهمان است، چون تنها راه اطمینان از پیشرفت هوش مصنوعی در مسیر درست همین بود.»
Daniela Amodei: «مأموریت ما هم روشن است و هم خالص؛ وضعیتی که در صنعت فناوری چندان رایج نیست.»
تفسیرپذیری: شبکههای عصبی دنیایی از «زیستشناسی مصنوعی» در خود دارند
Chris Olah: «شبکههای عصبی بسیار زیبا هستند و زیباییهای زیادی دارند که هنوز ندیدهایم. گاهی تصور میکنم ده سال دیگر وارد یک کتابفروشی شوم، کتابی درسی دربارهٔ زیستشناسی شبکههای عصبی بخرم و در آن انواع چیزهای شگفتانگیز را ببینم.»
استفاده از هوش مصنوعی برای تقویت دموکراسی، نه تبدیل آن به ابزار اقتدارگرایی
Dario Amodei: «نگرانیم که اگر هوش مصنوعی بهاشتباه توسعه داده شود، به ابزاری برای اقتدارگرایی تبدیل شود. چگونه هوش مصنوعی را به ابزاری برای ترویج آزادی و خودمختاری تبدیل کنیم؟ اهمیت این حوزه کمتر از زیستشناسی و تفسیرپذیری نیست.»
از نشستهای کاخ سفید تا جایزهٔ نوبل: تأثیر هوش مصنوعی مدتهاست از حلقه فناوری فراتر رفته است
Jared Kaplan: «در سال 2018، فکرش را هم نمیکردید که رئیسجمهور شما را به کاخ سفید دعوت کند تا بگوید در حال بررسی یک مدل زبانی هستند.»
Dario Amodei: «دیدیم که جایزهٔ نوبل شیمی به AlphaFold تعلق گرفت و باید برای توسعهٔ ابزارهایی تلاش کنیم که بتوانند به ساخت صدها ابزار مشابه AlphaFold کمک کنند.»
قیمت --
چرا هوش مصنوعی را مطالعه کنیم؟
Jack Clark: اصلاً چرا کار روی هوش مصنوعی را شروع کردیم؟ Jared، چرا در حوزهٔ هوش مصنوعی کار میکنی؟
Jared Kaplan: «مدت زیادی پیش از آن فیزیک کار کردم، کمی خسته شده بودم و دلم میخواست با دوستان بیشتری کار کنم؛ بنابراین وارد حوزهٔ هوش مصنوعی شدم.»
Tom Brown: «فکر میکردم Dario تو را قانع کرده است.»
Dario Amodei: «فکر نمیکنم صریحاً “قانعَت” کرده باشم؛ فقط مدام نتایج مدلهای هوش مصنوعی را به تو نشان میدادم و سعی میکردم کاربرد گستردهٔ آنها را منتقل کنم، نه اینکه فقط برای یک مسئله باشند. بالاخره بعد از اینکه بهاندازهٔ کافی نشان دادم، گفتی: “خب، به نظر درست میآید.”»
Jack Clark: Chris، وقتی روی پژوهش تفسیرپذیری کار میکردی، آن زمان همه را در Google میشناختی؟
Chris Olah: «نه. راستش وقتی در 19سالگی برای اولین بار به منطقهٔ خلیج سانفرانسیسکو آمدم، بسیاری از شما را میشناختم. همان موقع با Dario و Jared آشنا شدم؛ آنها پژوهشگر پسادکتری بودند و آن زمان به نظرم خیلی باحال میآمدند. بعدتر Dario به Google Brain پیوست و مدتی کنار هم مینشستیم؛ با Tom هم کار کردم. سپس وقتی به OpenAI رفتم، با همهٔ شما همکاری کردم.»
Jack Clark: «یادم میآید در کنفرانسی در سال 2015 با Dario آشنا شدم و میخواستم با تو مصاحبه کنم. روابط عمومی Google حتی گفت اول باید همهٔ مقالههایت را بخوانم.»
Dario Amodei: «آن زمان در Google مشغول نوشتن مقالهٔ “مسائل ملموس در ایمنی هوش مصنوعی” بودم.»
Sam McCandlish: «پیش از اینکه کار با شما را شروع کنم، به دفتر دعوتَم کردی تا گپ بزنیم و انگار هوش مصنوعی را بهطور کلی برایم توضیح دادی. یادم هست بعد از گفتوگو با خودم گفتم: “وای، این موضوع خیلی جدیتر از چیزی است که تصور میکردم.” دربارهٔ “انبوه محاسبات”، تعداد پارامترها، مقیاس نورونهای مغز انسان و چیزهای دیگر صحبت کردی.»
مقیاسپذیری تحولآفرین
Jack Clark: «یادم میآید در OpenAI، وقتی روی قوانین مقیاسپذیری کار میکردیم، بزرگتر کردن مدلها واقعاً جواب داد و در پروژههای زیادی بهشکلی عجیب خوب عمل کرد؛ از GPT-2 تا قوانین مقیاسپذیری و GPT-3. به همین شکل بود که مدام جلوتر رفتیم.»
Dario Amodei: «ما از آن آدمهایی هستیم که کار را به سرانجام میرسانند.»
Jared Kaplan: «ما به ایمنی هم بسیار علاقهمند بودیم. آن زمان این ایده مطرح بود که هوش مصنوعی بسیار قدرتمند خواهد شد، اما شاید ارزشهای انسانی را درک نکند و حتی نتواند با ما ارتباط برقرار کند. مدلهای زبانی تا حدی تضمین میکنند که بخش زیادی از دانش ضمنی را درک میکند.»
Dario Amodei: «RLHF هم روی مدلهای زبانی قرار میگیرد. یکی از انگیزههای افزایش مقیاس مدل در آن زمان این بود که مدل باید آنقدر هوشمند میشد تا RLHF بتواند کار کند. هنوز هم به همین موضوع باور داریم: ایمنی و مقیاسپذیری به هم گره خوردهاند.»
Chris Olah: «بله، کار مقیاسپذیری آن زمان در واقع بخشی از تیم ایمنی هم بود، چون احساس میکردیم برای اینکه مردم ایمنی را جدی بگیرند، ابتدا باید بتوانیم روندهای هوش مصنوعی را پیشبینی کنیم.»
Jack Clark: «یادم میآید در فرودگاهی در بریتانیا بودم، اخبار جعلی GPT-2 را بررسی میکردم و بعد در Slack برای Dario فرستادم و گفتم: “این واقعاً جواب میدهد و میتواند تأثیر زیادی بر سیاستگذاری داشته باشد.” یادم هست Dario جواب داد: “بله.”»
بعدتر کارهای زیادی هم در ارتباط با انتشار انجام دادیم که دیوانهوار بود.
Daniela Amodei: «آن دورهٔ انتشار را به یاد دارم؛ همان زمان بود که واقعاً و در جریان انتشار GPT-2 همکاریمان را شروع کردیم.»
Jack Clark: «فکر میکنم آن کار خیلی به ما کمک کرد. اول با هم کاری “کمی عجیب اما معطوف به ایمنی” انجام دادیم و بعد Anthropic را راه انداختیم؛ کاری بزرگتر، اما به همان اندازه عجیب و معطوف به ایمنی.»
روزهای نخست هوش مصنوعی
Tom Brown: «به مقالهٔ “مسائل ملموس” برگردیم. من در سال 2016 به OpenAI پیوستم و آن زمان من و تو جزو نخستین گروهها بودیم. به نظرم این مقاله شبیه نخستین مقالهٔ جریان اصلی دربارهٔ ایمنی هوش مصنوعی بود. چطور شکل گرفت؟»
Dario Amodei: «Chris میداند، او در آن مشارکت داشت. آن زمان در Google بودیم و یادم نیست پروژهٔ اصلیام چه بود؛ حس میکردم کاری است که مدام انجامش را عقب میاندازم.»
میخواستیم مسئلههای حلنشده در ایمنی هوش مصنوعی را مستند کنیم. آن زمان اغلب دربارهٔ ایمنی هوش مصنوعی بهشکلی انتزاعی صحبت میشد و ما میخواستیم آن را به یادگیری ماشین در دنیای واقعی پیوند بدهیم. این خط کاری شش یا هفت سال است که ادامه دارد، اما در آن زمان ایدهای عجیب به نظر میرسید.
Chris Olah: «فکر میکنم این کار بهنوعی تقریباً یک پروژهٔ سیاسی بود. آن زمان افراد زیادی ایمنی را جدی نمیگرفتند. میخواستیم فهرستی از مسائل تهیه کنیم که همه معقول بودنشان را بپذیرند؛ بسیاری از آنها پیشتر در متون علمی مطرح شده بودند. بعد هم افراد معتبر از نهادهای مختلف را پیدا کنیم تا آن را امضا کنند.»
یادم هست مدت زیادی با بیش از بیست پژوهشگر در Brain گفتوگو کردم تا برای انتشار حمایت جلب کنیم. امروز که به گذشته نگاه میکنم، شاید همهٔ مسائل مشخص مطرحشده همچنان معتبر نباشند و شاید دقیقترین صورتبندیها هم نبوده باشند. اما اگر آن را تلاشی برای ایجاد اجماع بدانیم تا نشان دهیم «اینجا مسائل واقعیای وجود دارد که شایستهٔ توجه جدیاند»، آن اتفاق مهمی بود.
Jack Clark: «بالاخره وارد دنیایی علمیتخیلی و بسیار عجیب میشوید. یادم هست در روزهای نخست Anthropic دربارهٔ هوش مصنوعی مبتنی بر قانون اساسی صحبت میکردیم و Jared گفت: “برای مدل زبانی یک قانون اساسی بنویسیم تا رفتارش تغییر کند.” آن زمان دیوانهوار به نظر میرسید. چرا فکر کردید شدنی است؟»
Jared Kaplan: «مدت زیادی دربارهاش با Dario صحبت کردم و فکر میکنم روشهای ساده در هوش مصنوعی اغلب بهشکلی غیرمنتظره خوب جواب میدهند. نسخههای اولیه بسیار پیچیده بودند، اما پیوسته سادهتر شدند تا اینکه به استفاده از توانایی مدل در پرسشهای چندگزینهای رسیدیم: صریحاً به آن میگفتیم دنبال چه چیزی بگردد و بعد میتوانستیم اصول را مستقیم بنویسیم.»
Dario Amodei: «این موضوع به “انبوه محاسبات”، “درس تلخ” و “فرضیهٔ مقیاسپذیری” برمیگردد: تا وقتی بتوانید هدف و دادهٔ روشنی به هوش مصنوعی بدهید، میتواند یاد بگیرد. مجموعهای از دستورها یا اصول را مدلهای زبانی میتوانند بخوانند و رفتارشان را با آن مقایسه کنند؛ هدف آموزش هم دقیقاً همانجاست. بنابراین Jared و من باور داشتیم که اگر جزئیات را تکرارشونده اصلاح کنیم، میتوانیم آن را عملی کنیم.»
Jared Kaplan: «در روزهای نخست همهچیز برایم بسیار عجیب بود. از فیزیک آمده بودم و حالا همه به هوش مصنوعی علاقهمندند؛ برای همین بهآسانی میشود حالوهوای آن دوران را فراموش کرد. آن زمان که با Dario دربارهٔ این موضوعات صحبت میکردم، احساس میکردم بسیاری از پژوهشگران هوش مصنوعی از نظر روانی از زمستان هوش مصنوعی آسیب دیدهاند؛ انگار “بلندپروازی” مجاز نبود. برای صحبت از ایمنی، اول باید باور میکردیم که هوش مصنوعی میتواند بسیار قدرتمند و مفید باشد، اما آن زمان تقریباً بلندپروازی ممنوع بود. فیزیکدانها از نوعی “غرور” برخوردارند؛ اغلب سراغ کارهای بلندپروازانه میروند و راحت دربارهٔ چشماندازهای بزرگ حرف میزنند.»
Dario Amodei: «فکر میکنم درست است؛ در سال 2014 خیلی چیزها را نمیشد گفت. این مشکل کلی دانشگاهها هم هست، بهجز بعضی حوزهها؛ نهادها هرچه بیشتر از ریسککردن پرهیز میکنند. هوش مصنوعی صنعتی هم این طرز فکر را به ارث برده و بهنظرم تازه حدود سال 2022 از آن فاصله گرفت.»
Chris Olah: «دو نوع “محافظهکاری” وجود دارد: یکی جدی گرفتن ریسکها و دیگری اینکه جدی گرفتن ریسک و باور به موفقیت ایدهها را نوعی غرور بدانیم. آن زمان نوع دوم بر ما غالب بود. در تاریخ، در بحثهای فیزیک هستهای سال 1939 هم وضعیت مشابهی پیش آمد: Fermi محتاط بود، درحالیکه Szilard یا Teller ریسکها را جدیتر میگرفتند.»
Dario Amodei: «عمیقترین درسی که در دههٔ گذشته گرفتهام این است که بسیاری از اجماعهای مبتنی بر “همه میدانند”، در واقع اثر گلهایای هستند که خود را در لباس بلوغ پنهان میکنند. وقتی چند بار ببینید اجماع یکشبه تغییر میکند، میگویید: “نه، ما روی این موضوع شرط میبندیم.” شاید لزوماً درست نباشد، اما سروصدا را نادیده میگیرید و شرطتان را میبندید. حتی اگر فقط %50 درست بگویید، چیزهای زیادی اضافه میکنید که دیگران ارائه نکردهاند.»
نگرش عمومی به هوش مصنوعی
Jared Kaplan: «امروز هم در بعضی مسائل ایمنی وضع همینطور است: اجماع بیرونی میگوید بسیاری از مسائل ایمنی بهطور طبیعی از فناوری پدید نمیآیند، اما در پژوهشهای ما در Anthropic دیدهایم که واقعاً بهشکل طبیعی پدید میآیند.»
Daniela Amodei: «اما در 18 ماه گذشته این وضعیت تغییر کرده است. همزمان، احساسات مردم دنیا نسبت به هوش مصنوعی هم آشکارا تغییر کرده است. وقتی پژوهش کاربر انجام میدهیم، بیشتر از قبل میشنویم که کاربران عادی دربارهٔ تأثیر کلی هوش مصنوعی بر جهان ابراز نگرانی میکنند.»
گاهی نگرانی دربارهٔ کار، سوگیری یا محتوای سمی است؛ گاهی دربارهٔ اینکه «آیا جهان را بههم میریزد و شیوهٔ همکاری انسانها را تغییر میدهد؟» اینها چیزهایی بودند که کاملاً پیشبینی نکرده بودم.
Sam McCandlish: «بهدلایلی، جامعهٔ پژوهشی یادگیری ماشین اغلب دربارهٔ “بسیار قدرتمند شدن هوش مصنوعی” از عموم مردم بدبینتر است.»
Jared Kaplan: «در سال 2023، من و Dario به کاخ سفید رفتیم و در جلسه، Harris و Raimondo در اصل میگفتند: حواسمان به شما هست؛ هوش مصنوعی موضوع مهمی است و با جدیت آن را دنبال میکنیم. اما در سال 2018، فکرش را نمیکردید که “رئیسجمهور شما را به کاخ سفید دعوت کند و بگوید مدلهای زبانی را زیر نظر دارند”.»
Tom Brown: «نکتهٔ جالب این است که خیلی از ما وقتی وارد این حوزه شدیم که هنوز همهچیز نامطمئن بود؛ مثل Fermi و بمب اتم، که شواهدی وجود داشت مبنی بر اینکه میتوان بمب را ساخت، اما شواهد زیادی هم خلاف آن بود. بااینحال، در نهایت تصمیم گرفت تلاش کند، چون اگر این کار شدنی بود، تأثیرش چشمگیر میشد و ارزش پیگیری داشت.»
از سال 2015 تا 2017 شواهد فزایندهای وجود داشت که هوش مصنوعی میتواند موضوع مهمی باشد. در سال 2016 با یکی از مربیانم صحبت کردم: پیشتر استارتاپهایی راه انداخته بودم و میخواستم روی ایمنی هوش مصنوعی کار کنم، اما ریاضیام بهاندازهٔ کافی قوی نبود و نمیدانستم چه کنم. آن زمان عدهای میگفتند باید در نظریهٔ تصمیمگیری مهارت داشته باشید، عدهای میگفتند اتفاق دیوانهواری در حوزهٔ هوش مصنوعی رخ نخواهد داد و افراد بسیار کمی واقعاً حمایت میکردند.
Jack Clark: «در سال 2014، وقتی گزارش روندهای ImageNet را نوشتم، مردم فکر کردند دیوانهام. در سال 2015، وقتی خواستم دربارهٔ اشارهٔ NVIDIA به GPUها در مقالهها بنویسم، باز هم فکر کردند دیوانهام. در سال 2016، وقتی روزنامهنگاری را رها کردم و به حوزهٔ هوش مصنوعی رفتم، حتی ایمیلهایی دریافت کردم که میگفتند: “بزرگترین اشتباه زندگیات را کردی.” از بسیاری جهات، آن زمان شرطبندی جدی روی اینکه “مقیاسپذیری اتفاق میافتد” واقعاً دیوانهوار به نظر میرسید.»
Jared Kaplan: «چطور تصمیم گرفتی؟ دودل بودی؟»
Jack Clark: «یک شرطبندی معکوس کردم: خواستم خبرنگار تماموقت هوش مصنوعی شوم و حقوقم دو برابر شود؛ میدانستم قبول نمیکنند. بعد از یک شب خوابیدن روی موضوع استعفا دادم. چون هر روز اسناد بایگانیشده را میخواندم، همیشه حس میکردم اتفاقی دیوانهوار در جریان است و بالاخره باید با اطمینان بالا، شرط بزرگی ببندی.»
Tom Brown: «من آنقدر قاطع نبودم؛ شش ماه تردید کردم.»
Daniela Amodei: «آن زمان این ایده که “مهندسان هم میتوانند نقش مهمی در پیشبرد هوش مصنوعی داشته باشند” جریان اصلی نبود. تصور میشد “فقط پژوهشگران میتوانند روی هوش مصنوعی کار کنند”، پس تردیدت عجیب نیست.»
Tom Brown: «بعدتر OpenAI گفت: “با مهندسی میتوانی به ایمنی هوش مصنوعی کمک کنی” و همین باعث شد بپیوندم. Daniela، وقتی در OpenAI بودی یا مدیر من بودی، چرا آن زمان به آنجا پیوستی؟»
Daniela Amodei: «پنج سال و نیم در Stripe بودم و Greg مدیرم بود. من Greg و Dario را هم به یکدیگر معرفی کردم. او در حال تأسیس OpenAI بود و به او گفتم: “باهوشترین کسی که میشناسم Dario است. اگر بتوانی او را به گروهت بیاوری، خیلی خوششانس خواهی بود.” بعدتر Dario به OpenAI پیوست.»
شاید مثل تو، پس از ترک Stripe مدام به این فکر میکردم که بعدش چه کنم. به Stripe پیوستم چون احساس میکردم باید مهارتهای بیشتری به دست بیاورم؛ مهارتهایی که از کارهای قبلیام در سازمانهای غیرانتفاعی و توسعهٔ بینالمللی به دست نیاورده بودم. فکر میکردم شاید در نهایت به همان حوزه برگردم.
پیش از پیوستن به Stripe احساس میکردم توانایی کافی برای کمک به افرادی را که از من محرومترند ندارم. بنابراین شرکتهای فناوری دیگری را بررسی میکردم تا راه تازهای برای ایجاد تأثیری بزرگتر پیدا کنم و OpenAI در آن زمان گزینهٔ مناسبی به نظر میرسید. سازمانی غیرانتفاعی بود که به هدفی بسیار مهم و تأثیرگذار متعهد شده بود.
بهخاطر شناختی که از Dario داشتم، همیشه به ظرفیت هوش مصنوعی باور داشتم و آنها واقعاً به کمک در مدیریت نیاز داشتند؛ بنابراین احساس کردم این نقش با پیشینهٔ من تناسب زیادی دارد. با خودم فکر کردم: «این یک سازمان غیرانتفاعی با گروهی از افراد فوقالعاده و چشماندازی والا است، اما به نظر میرسد عملیاتش کمی آشفته باشد.» این چالش هیجانزدهام کرد، چون میتوانستم وارد عمل شوم.
آن زمان احساس میکردم عضوی چندمنظوره هستم؛ نهتنها مسئول مدیریت اعضای تیم و هدایت بعضی تیمهای فناوری بودم، بلکه در گسترش سازمان هم نقش داشتم. کارهای گسترش سازمانی را انجام میدادم، در تیم زبان کار کردم و بعدتر مسئولیتهای دیگری پذیرفتم. در برخی مسائل سیاستگذاری مشارکت داشتم و با Chris همکاری میکردم. افراد بااستعداد زیادی در شرکت میدیدم و همین باعث میشد مشتاق باشم به آن بپیوندم و به کارآمدتر و منظمتر شدن شرکت کمک کنم.
Jack Clark: «یادم هست بعد از تمام کردن GPT-3 گفتی: “دربارهٔ اعتماد و ایمنی چیزی شنیدهای؟”»
Daniela Amodei: «قبلاً سرپرست تیم اعتماد و ایمنی در Stripe بودم. برای فناوریای از این نوع شاید لازم باشد به جنبهٔ اعتماد و ایمنی هم توجه کنید. این موضوع در واقع میان پژوهش ایمنی هوش مصنوعی و کار عملی روزمره پل میزند؛ یعنی اینکه چطور مدل را واقعاً ایمن کنیم.»
بسیار مهم است که مطرح کنیم «این فناوری در آینده تأثیر چشمگیری خواهد داشت». درعینحال، باید هر روز کارهای عملیتری انجام دهیم تا زمینهٔ لازم برای مواجهه با موقعیتهای پرخطرتر در آینده فراهم شود.
سیاست گسترش مسئولانه: تضمین توسعهٔ ایمن هوش مصنوعی
Jack Clark: «بیایید دربارهٔ شکلگیری سیاست گسترش مسئولانه (RSP)، دلیل مطرح شدن آن و نحوهٔ اجرای امروزش صحبت کنیم؛ بهخصوص با توجه به کارهایی که در زمینهٔ اعتماد و امنیت مدل انجام دادهایم. پس چه کسی ابتدا RSP را پیشنهاد کرد؟»
Dario Amodei: «این سیاست را ابتدا من و Paul Christiano، حدود پایان سال 2022، مطرح کردیم. ایدهٔ اولیه این بود که آیا باید پیش از آنکه مدل به سطح معینی برسد، موقتاً محدودش کنیم تا زمانی که راهی برای حل بعضی مسائل ایمنی پیدا کنیم؟»
اما بعدتر احساس کردیم محدود کردن مقیاس در نقطهای مشخص و سپس برداشتن محدودیت، کمی عجیب است. بنابراین تصمیم گرفتیم مجموعهای از آستانهها تعیین کنیم و هر بار که مدل به یکی از آنها میرسد، یک سری آزمون انجام شود تا ببینیم آیا مدل توانایی ایمنی متناسب را دارد یا نه.
در هر آستانه باید اقدامات امنیتی و ایمنی سختگیرانهتری انجام دهیم. بااینحال، ابتدا این ایده را داشتیم که بهتر است اجرای این سیاست بر عهدهٔ شخص ثالثی باشد. بهعبارت دیگر، نباید مسئولیت این سیاست فقط بر دوش یک شرکت باشد، چون ممکن است شرکتهای دیگر تمایلی به پذیرش آن نداشته باشند. بنابراین Paul شخصاً این سیاست را طراحی کرد. البته با گذشت زمان، جزئیات زیادی هم تغییر کردهاند و تیم ما در حال پژوهش دربارهٔ راههایی است که اجرای این سیاست را بهتر میکنند.
وقتی Paul این مفهوم را رسمی کرد، تقریباً همزمان با اعلام آن، ما هم نسخهٔ خودمان را ظرف یکی دو ماه منتشر کردیم. در واقع، بسیاری از اعضای تیم ما عمیقاً در این فرایند نقش داشتند. یادم هست دستکم یکی از پیشنویسهای اولیه را خودم نوشتم، اما کل سند چندین بار بازنگری شد.
Tom Brown: «برای Anthropic، RSP مثل “قانون اساسی” ماست. سندی بنیادی و راهنماست، بنابراین حاضریم زمان و تلاش زیادی صرف کنیم و بارها اصلاحش کنیم تا از دقت و کامل بودن آن مطمئن شویم.»
Daniela Amodei: «بهنظرم شکلگیری RSP در Anthropic واقعاً جالب بوده است. این فرایند چندین مرحله را پشت سر گذاشته و اجرای آن به مهارتهای گوناگونی نیاز دارد. برای مثال، بعضی ایدههای کلان وجود دارند که عمدتاً افرادی مانند Dario، Paul، Sam و Jared هدایتشان میکنند. آنها به این فکر میکنند که “اصول اصلی ما چیست؟ میخواهیم چه پیامی منتقل کنیم؟ چطور مطمئن شویم مسیرمان درست است؟”»
اما علاوه بر آن، کار جنبهای عملیاتی و بسیار کاربردی هم دارد؛ مثلاً در فرایند تکرار و اصلاح مداوم، بعضی جزئیات را ارزیابی و تنظیم میکنیم. برای نمونه، در ابتدا انتظار داشتیم در سطح مشخصی از ایمنی به هدفهای معینی برسیم؛ اما اگر به آنها نرسیده باشیم، دوباره ارزیابی میکنیم و مطمئن میشویم که میتوانیم در قبال نتایج کارمان پاسخگو باشیم.
همچنین، تغییرات زیادی در ساختار سازمانی انجام میشود. برای نمونه، تصمیم گرفتیم ساختار سازمانی RSP را از نو طراحی کنیم تا مسئولیتها روشن شوند. برای تأکید بر اهمیت این سند، دوست دارم آن را به قانون اساسی تشبیه کنم. همانطور که ایالات متحده مجموعهای از نهادها مانند دادگاهها، دیوان عالی، رئیسجمهور و دو مجلس کنگره را برای تضمین اجرای قانون اساسی ایجاد کرد، با اینکه این نهادها مسئولیتهای دیگری هم دارند، وجودشان تا حد زیادی برای پاسداری از قانون اساسی است؛ RSP در Anthropic هم فرایندی مشابه را طی میکند.
Sam McCandlish: «فکر میکنم این موضوع در واقع دیدگاه اصلی ما دربارهٔ مسائل امنیتی را نشان میدهد: مسائل امنیتی قابل حل هستند. این کاری بسیار پیچیده و چالشبرانگیز است که به زمان و تلاش زیادی نیاز دارد.»
همانند حوزهٔ ایمنی خودرو که نهادها و سازمانهای مرتبط با آن طی سالها فعالیت ایجاد شدهاند، اکنون با این مسئله روبهرو هستیم: آیا برای انجام این کار بهاندازهٔ کافی زمان داریم؟ بنابراین باید نهادهای کلیدی موردنیاز برای ایمنی هوش مصنوعی را سریع شناسایی کنیم و ابتدا آنها را در اینجا ایجاد کنیم؛ درعینحال مطمئن شویم که میتوان از این نهادها در جاهای دیگر هم الگوبرداری کرد و آنها را گسترش داد.
Dario Amodei: «این کار به همکاری درونسازمانی هم کمک میکند؛ چون اگر رفتار هر بخشی از سازمان با ارزشهای امنیتی ما سازگار نباشد، RSP بهنوعی آن را آشکار میکند، درست است؟ RSP مانع ادامهٔ برنامههایی میشود که معیارهای امنیتی را برآورده نمیکنند. بنابراین به ابزاری تبدیل میشود که پیوسته به همه یادآوری میکند امنیت باید یکی از الزامات اساسی در فرایند توسعه و برنامهریزی محصول باشد. ما فقط شعار نمیدهیم، بلکه امنیت را واقعاً در همهٔ ابعاد ادغام میکنیم. اگر کسی به تیم بپیوندد و نتواند با این اصول هماهنگ شود، سازگار شدن با محیط برایش دشوار خواهد بود. یا با این مسیر هماهنگ میشود یا ادامه دادن برایش دشوار خواهد شد.»
Jack Clark: «با گذشت زمان، اهمیت RSP بیشتر و بیشتر شده است. هزاران ساعت برای آن کار کردهایم و وقتی RSP را برای سناتورها توضیح میدهم، میگویم: “اقداماتی در نظر گرفتهایم تا مطمئن شویم فناوریمان بهراحتی مورد سوءاستفاده قرار نمیگیرد و ایمنی را هم تضمین میکند.” پاسخ معمول آنها این است: “طبیعی به نظر میرسد. مگر همهٔ شرکتها همین کار را نمیکنند؟” این جواب کمی خندهام میاندازد و کمی هم باعث میشود گریهام بگیرد؛ در واقع، همهٔ شرکتها این کار را نمیکنند.»
Daniela Amodei: «علاوه بر این، فکر میکنم RSP در کنار همسو کردن ارزشهای تیم، شفافیت شرکت را هم افزایش داده است. چون هدفهای ما را بهروشنی مستند میکند؛ همهٔ افراد داخل شرکت میتوانند آنها را درک کنند و افراد بیرون از شرکت هم میتوانند از هدفها و مسیر امنیتی ما آگاه شوند. هرچند این سیاست بینقص نیست، پیوسته آن را بهینه و بهتر میکنیم.»
فکر میکنم باید صریحاً بیان کنیم «روی چه مسئلهٔ اصلیای تمرکز داریم»، چون نمیتوانیم بیمحابا از واژهٔ «امنیت» برای اثر گذاشتن بر روند کار استفاده کنیم؛ مثلاً بگوییم «بهدلیل یک مسئلهٔ امنیتی نمیتوانیم کاری انجام دهیم» یا «بهدلیل یک مسئلهٔ امنیتی باید کاری انجام دهیم». هدف واقعی ما این است که مطمئن شویم همه منظورمان از امنیت را درک میکنند.
Dario Amodei: «در بلندمدت، چیزی که واقعاً به امنیت آسیب میزند، اغلب همان “مانورهای امنیتی” مکرر است. گفتهام: “اگر آژیر آتشنشانی ساختمانی هر هفته به صدا دربیاید، آن ساختمان در واقع بسیار ناایمن است.” چون وقتی آتشسوزی واقعی رخ دهد، ممکن است کسی توجهی نکند؛ پس باید به دقت و تنظیم درست آژیر توجه زیادی داشته باشیم.»
Chris Olah: «از زاویهای دیگر، فکر میکنم RSP در سطوح مختلف سازوکارهای انگیزشی سالمی ایجاد کرده است. برای نمونه، در داخل شرکت، RSP سازوکارهای انگیزشی هر تیم را با هدفهای امنیتی هماهنگ میکند؛ یعنی اگر در زمینهٔ امنیت پیشرفت کافی نداشته باشیم، کارهای مرتبط متوقف خواهند شد.»
Jared Kaplan: «با این نکات موافقم، اما فکر میکنم شاید این دیدگاه، دشواریهایی را که در تدوین سیاستهای مناسب، ارزیابی معیارها و تعیین مرزها با آن روبهرو هستیم، دستکم بگیرد. در این حوزهها بارها و بارها بازنگری کردهایم و همچنان به بهینهسازی ادامه میدهیم. یکی از مسائل دشوار این است که درباره بعضی فناوریهای نوظهور، گاهی نمیتوان با قطعیت تعیین کرد که خطرناکاند یا بیخطر. در بسیاری از مواقع با محدودهای خاکستری و گسترده روبهرو میشویم. این چالشها در مراحل اولیه توسعه RSP برایم بسیار هیجانانگیز بودند و هنوز هم هستند. بااینحال، همزمان متوجه شدهام که اجرای روشن این استراتژی و واقعاً مؤثر کردن آن، پیچیدهتر و دشوارتر از چیزی است که در ابتدا تصور میکردم.»
Sam McCandlish: «محدودههای خاکستری غیرقابلپیشبینیاند، چون همهجا وجود دارند. فقط وقتی واقعاً اجرای کار را شروع میکنید، میتوانید مشکلات را کشف کنید. بنابراین هدف ما این است که همهچیز را در اولین فرصت اجرا کنیم تا بتوانیم مشکلات احتمالی را سریع شناسایی کنیم.»
Dario Amodei: «برای رسیدن واقعی به کمال، باید سه تا چهار بار تکرار و بازنگری کنید. تکرار و بازنگری ابزار بسیار قدرتمندی است؛ تقریباً هیچوقت نمیتوانید همهچیز را در نخستین تلاش کاملاً درست انجام دهید. بنابراین اگر خطرها رو به افزایشاند، باید این مراحل را زودتر تکمیل کنید، نه اینکه تا پایان منتظر بمانید.»
Jack Clark: «درعینحال، باید سیاستها و فرایندهای داخلی را هم تدوین کنید. جزئیات مشخص ممکن است بهمرور تغییر کنند، اما تقویت توان اجرایی تیم از اهمیت بالایی برخوردار است.»
Tom Brown: «من مسئول مدیریت منابع محاسباتی Anthropic هستم. از نظر من، باید با ذینفعان بیرونی ارتباط برقرار کنیم، چون طرفهای مختلف خارج از شرکت درباره سرعت پیشرفت فناوری دیدگاههای متفاوتی دارند. ابتدا فکر میکردم فناوری اینقدر سریع پیشرفت نمیکند، اما بعداً نظرم تغییر کرد و به همین دلیل واقعاً میتوانم با این موضوع ارتباط برقرار کنم. RSP را در مورد خودم بهویژه مفید میدانم، خصوصاً هنگام صحبت با کسانی که فکر میکنند فناوری بهکندی پیشرفت خواهد کرد. میتوانیم به آنها بگوییم: «تا وقتی فناوری به سطحی بحرانی نرسیده، نیازی به اتخاذ تدابیر امنیتی افراطی نداریم.» اگر بگویند «فکر میکنم تا مدتها شرایط اضطراری نمیشود»، میتوانم پاسخ بدهم: «بسیار خوب، پس فعلاً نیازی به اتخاذ تدابیر امنیتی افراطی نداریم.» این کار ارتباط با دنیای بیرون را بسیار روانتر میکند.»
Jack Clark: «پس RSP از چه راههایی بر همه تأثیر گذاشته است؟»
Sam McCandlish: «همهچیز حول ارزیابی میچرخد؛ هر تیمی در حال انجام ارزیابی است. برای مثال، تیم آموزش شما دائماً ارزیابی میکند. تلاش میکنیم مشخص کنیم که آیا این مدل بهاندازهای قدرتمند شده که احتمالاً خطرآفرین باشد یا نه.»
Daniela Amodei: «درواقع، این یعنی باید عملکرد مدل را طبق استانداردهای RSP بسنجیم، ازجمله اینکه بررسی کنیم آیا نشانههایی وجود دارد که باعث نگرانی ما شود یا نه.»
Sam McCandlish: «ارزیابی حداقل تواناییهای مدل نسبتاً آسان است، اما سنجش حداکثر تواناییهای آن بسیار دشوار است. به همین دلیل، تلاش پژوهشی زیادی را صرف پاسخدادن به پرسشهایی از این دست کردهایم: «آیا این مدل میتواند برخی کارهای خطرناک را انجام دهد؟ آیا روشهایی را در نظر نگرفتهایم، مثل نقشهبرداری ذهنی، بهترین رویداد یا استفاده از ابزارهای خاص، که ممکن است مدل را قادر به انجام رفتارهایی با ریسک بالا کنند؟»»
Jack Clark: «این ابزارهای ارزیابی در فرایند سیاستگذاری بسیار مفیدند. چون «امنیت» مفهومی بسیار انتزاعی است، وقتی میگویم «ابزاری برای ارزیابی داریم که مشخص میکند آیا میتوانیم این مدل را عرضه کنیم یا نه»، میتوانیم با سیاستگذاران، متخصصان امنیت ملی و کارشناسان حوزه CBRN (شیمیایی، زیستی، پرتوی و هستهای) همکاری کنیم تا معیارهای ارزیابی دقیقی را با هم تدوین کنیم. بدون این ابزارهای مشخص، شاید اصلاً چنین همکاریهایی ممکن نباشد. اما وقتی استانداردهای روشنی داشته باشیم، افراد تمایل بیشتری پیدا میکنند که برای اطمینان از دقت آنها مشارکت کنند. بنابراین نقش RSP از این نظر بسیار مهم است.»
Daniela Amodei: «RSP برای من هم بسیار مهم است و اغلب بر کارم تأثیر میگذارد. برایم جالب است که شیوه تفکرم درباره RSP تا حدی خاص است و بیشتر به «لحن» آن، یعنی نحوه بیانش، مربوط میشود. اخیراً لحن RSP را بهطور چشمگیری تغییر دادهایم، چون لحن قبلی بیشازحد فنی و حتی تا حدی تقابلی بود. زمان زیادی را صرف فکرکردن به این موضوع کردم که چطور سیستمی بسازیم که مردم تمایل داشته باشند با آن تعامل کنند.»
«اگر RSP سندی بود که همه افراد شرکت بهراحتی میتوانستند آن را درک کنند، خیلی بهتر میشد؛ درست مثل OKRهای فعلی ما (اهداف و نتایج کلیدی). برای مثال، هدف اصلی RSP چیست؟ از کجا بفهمیم به هدف رسیدهایم؟ سطح امنیت هوش مصنوعی (ASL) در حال حاضر چیست؟ ASL-2 است یا ASL-3؟ اگر همه بدانند باید روی چه حوزههای کلیدی تمرکز کنند، شناسایی مشکلات احتمالی آسانتر میشود. برعکس، اگر RSP بیشازحد فنی باشد و فقط تعداد کمی از افراد بتوانند آن را درک کنند، کاربرد واقعیاش بهشدت کاهش مییابد.»
«خوشحالم که میبینم RSP بهسمت قابلفهمتر شدن پیش میرود. حالا فکر میکنم بیشتر افراد شرکت، شاید حتی همه آنها، فارغ از جایگاهشان، میتوانند این سند را بخوانند و بگویند: «این منطقی است. امیدوارم هوش مصنوعی را با راهنمایی این اصول توسعه دهیم و میفهمم چرا این مسائل مهماند. اگر در محل کار با مشکلی روبهرو شوم، تقریباً میدانم باید به چه نکاتی توجه کنم.» میخواهیم RSP را آنقدر ساده کنیم که کارکنان خط تولید بتوانند بهراحتی بگویند: «کمربند ایمنی باید اینجا بسته شود، اما الان بسته نشده است» و مشکلات را بهموقع تشخیص دهند.»
«نکته اصلی، ایجاد سازوکاری سالم برای بازخورد است تا ارتباط میان مدیران ارشد، هیئتمدیره، دیگر بخشهای شرکت و تیمهایی که واقعاً در تحقیقوتوسعه مشارکت دارند، روان باشد. فکر میکنم بیشتر مشکلات اغلب بهدلیل ارتباطات ضعیف یا تحریف اطلاعات به وجود میآیند. اگر مشکلات فقط به همین دلایل رخ دهند، واقعاً مایه تأسف خواهد بود، نه؟ در نهایت، باید این مفاهیم را در عمل پیاده کنیم و مطمئن شویم برای همه روشن و قابلدرکاند.»
داستان بنیانگذاری Anthropic
Sam McCandlish: «درواقع، هیچکدام از ما در ابتدا قصد راهاندازی یک شرکت را نداشتیم. فقط احساس میکردیم مسئولیت ماست و باید دستبهکار شویم، چون این تنها راهی بود که میتوانستیم مطمئن شویم توسعه هوش مصنوعی در مسیر درستی پیش میرود؛ به همین دلیل به آن متعهد شدیم.»
Dario Amodei: «ایده اولیه من خیلی ساده بود؛ فقط میخواستم چیزهای تازهای را به شکلی سودمند اختراع و کشف کنم. این ایده مرا به حوزه هوش مصنوعی کشاند؛ حوزهای که به پشتیبانی مهندسی فراوان و در نهایت به پشتیبانی مالی زیادی نیاز دارد.»
اما متوجه شدم که بدون هدف و برنامهای روشن برای تأسیس شرکت و مدیریت محیط کار، بسیاری از کارهایی که انجام میشوند، اشتباهات صنعت فناوری را تکرار میکنند؛ همان اشتباهاتی که باعث میشد احساس کنم به آن فضا تعلق ندارم. این اشتباهات اغلب از همان افراد، همان نگرشها و همان طرز فکر سرچشمه میگیرند. بنابراین در مقطعی فهمیدم که باید این کار را به روشی کاملاً تازه انجام دهیم؛ چیزی که تقریباً اجتنابناپذیر بود.
Jared Kaplan: «به یاد دارم زمانی که در مقطع تحصیلات تکمیلی بودیم، برنامه کاملی داشتی تا بررسی کنی پژوهش علمی چگونه میتواند منافع عمومی را پیش ببرد. فکر میکنم این موضوع بسیار شبیه طرز فکر امروزی ماست. یادم هست آن زمان پروژهای به نام «Project Vannevar» داشتی که هدفش تحقق همین موضوع بود. آن موقع استاد بودم، اوضاع را زیر نظر داشتم و عمیقاً باور داشتم که تأثیر هوش مصنوعی با سرعتی باورنکردنی در حال افزایش است.»
اما بهدلیل هزینههای مالی بالای پژوهش هوش مصنوعی و اینکه استاد فیزیک بودم، فهمیدم که نمیتوانم فقط به پژوهش دانشگاهی برای پیشبرد این پیشرفتها تکیه کنم. میخواستم با افراد قابلاعتماد همراه شوم و نهادی تأسیس کنم تا مطمئن شویم توسعه هوش مصنوعی در مسیر درستی قرار میگیرد. اما صادقانه بگویم، هرگز به کسی توصیه نمیکنم شرکتی راهاندازی کند و خودم هم هیچوقت چنین خواستهای نداشتم. برای من، این کار فقط وسیلهای برای رسیدن به هدف بود. باور دارم که معمولاً کلید موفقیت این است که واقعاً به دستیابی به هدفی معنادار برای جهان اهمیت بدهید و سپس بهترین راه رسیدن به آن هدف را پیدا کنید.
ایجاد فرهنگ اعتماد
Daniela Amodei: «اغلب به مزیتهای استراتژیک تیممان فکر میکنم. یکی از آنها که شاید کمی غیرمنتظره به نظر برسد، اما بسیار مهم است، سطح بالای اعتماد میان ماست. ایجاد مأموریتی مشترک برای گروه بزرگی از افراد بسیار دشوار است، اما در Anthropic توانستهایم این حس مأموریت را با موفقیت در میان افراد بیشتری ایجاد کنیم. در این تیم، از مدیران ارشد گرفته تا همه اعضا، همگی بهخاطر مأموریتی مشترک گرد هم آمدهایم. مأموریت ما هم روشن است و هم خالص؛ چیزی که در صنعت فناوری بهندرت دیده میشود.»
احساس میکنم هدفی که برای رسیدن به آن تلاش میکنیم، سرشار از حس عمیق هدفمندی است. هیچکدام از ما این کار را برای راهاندازی یک شرکت شروع نکردیم. فقط فکر میکردیم ضروری است. نمیتوانستیم در محل کار قبلیمان به همان شکل به کار ادامه دهیم و باید خودمان دستبهکار میشدیم.
Jack Clark: «آن زمان، با ظهور GPT-3 و پروژههایی که همه با آنها آشنا شده بودیم یا در آنها مشارکت داشتیم، مثل قوانین مقیاسپذیری، میتوانستیم روند هوش مصنوعی را در سال 2020 بهروشنی ببینیم. متوجه شدیم اگر سریع اقدام نکنیم، ممکن است بهزودی به نقطهای بازگشتناپذیر برسیم. باید برای اثرگذاری در این حوزه دستبهکار میشدیم.»
Tom Brown: «در ادامه حرف Daniela، واقعاً باور دارم که سطح اعتماد درون تیم بالاست. هرکدام از ما بهخوبی میدانیم که به این تیم پیوستیم چون میخواستیم به جهان کمک کنیم. همچنین همگی متعهد شدیم %80 از درآمدمان را به فعالیتهایی اهدا کنیم که میتوانند پیشرفت جامعه را رقم بزنند؛ تصمیمی که همه از صمیم قلب از آن حمایت کردند: «بله، حتماً این کار را میکنیم.» چنین سطحی از اعتماد بسیار ویژه و کمیاب است.»
Daniela Amodei: «به نظرم Anthropic شرکتی است که رنگوبوی سیاسی بسیار کمی دارد. البته ممکن است دیدگاه ما با دیدگاه افراد عادی تفاوت داشته باشد و دائماً این را به خودم یادآوری میکنم. باور دارم فرایند استخدام ما و ویژگیهای اعضای تیم، فرهنگی را در اینجا شکل دادهاند که ذاتاً با «سیاستبازی در محیط کار» مخالف است.»
Dario Amodei: «موضوع دیگر انسجام تیم است که اهمیتی اساسی دارد. چه تیم محصول باشد، چه تیم پژوهش، تیم اعتماد و ایمنی، تیم بازاریابی یا تیم سیاستگذاری، همه برای رسیدن به هدفی مشترک برای شرکت تلاش میکنند. وقتی بخشهای مختلف یک شرکت هدفهایی کاملاً متفاوت را دنبال کنند، اغلب هرجومرج به وجود میآید. بسیار غیرعادی است که آنها فکر کنند بخشهای دیگر در حال خرابکردن کارشان هستند.»
باور دارم یکی از مهمترین دستاوردهای ما، حفظ موفقیتآمیز انسجام کلی شرکت بوده است. سازوکارهایی مانند RSP نقشی اساسی در این زمینه دارند. این سازوکار تضمین میکند که کار به این شکل نباشد که بعضی بخشها مشکل ایجاد کنند و بقیه در داخل شرکت برای رفع آنها تلاش کنند؛ بلکه همه بخشها وظایف خود را انجام میدهند و در چارچوبی یکپارچه از نظریه تغییر با یکدیگر همکاری میکنند.
Chris Olah: «در ابتدا به OpenAI پیوستم چون سازمانی غیرانتفاعی بود و میتوانستم روی پژوهش ایمنی هوش مصنوعی تمرکز کنم. اما بهمرور متوجه شدم که این ساختار کاملاً مناسب من نیست و همین باعث شد تصمیمهای دشواری بگیرم. در تمام این فرایند، به قضاوت Dario و Daniela اعتماد زیادی داشتم، اما نمیخواستم بروم. برای رفتن تردید داشتم، چون باور نداشتم که اضافهشدن آزمایشگاههای بیشتر هوش مصنوعی الزاماً به نفع جهان باشد.»
وقتی در نهایت تصمیم گرفتیم برویم، هنوز درباره راهاندازی یک شرکت تردید داشتم. پیشتر استدلال کرده بودم که باید سازمانی غیرانتفاعی با تمرکز بر پژوهش ایمنی تأسیس کنیم. اما رویکردی عملگرایانه و پذیرش صادقانه محدودیتهای دنیای واقعی باعث شد بفهمیم تأسیس Anthropic بهترین راه برای رسیدن به اهدافمان است.
Dario Amodei: «یکی از درسهای مهمی که از همان ابتدا گرفتیم این بود: کمتر از توانمان وعده بدهیم و فراتر از وعدهمان عمل کنیم. واقعبین بمانیم و با بدهبستانها روبهرو شویم، چون اعتماد و اعتبار از هر سیاست مشخصی مهمترند.»
Daniela Amodei: «یکی از ویژگیهای منحصربهفرد Anthropic، سطح بالای اعتماد و اتحاد درون تیم است. برای مثال، وقتی میبینم Mike Krieger بهدلایل امنیتی بر عرضهنکردن بعضی محصولات پافشاری میکند و همزمان Vinay درباره چگونگی متعادلکردن نیازهای تجاری برای پیشبرد پروژهها صحبت میکند، حس ویژهای به من دست میدهد. علاوهبراین، اعضای تیم امنیت فنی و مهندسان تیم استدلال هم درباره چگونگی اطمینان از امن و کاربردیبودن محصول گفتوگو میکنند. این هدف مشترک و رویکرد عملگرایانه از جذابترین جنبههای محیط کاری Anthropic هستند.»
Dario Amodei: «فرهنگ سازمانی سالم یعنی همه بتوانند بدهبستانهایی را که بهطور جمعی با آنها روبهرو هستیم درک کنند و بپذیرند. دنیایی که در آن زندگی میکنیم کامل نیست و هر تصمیمی مستلزم ایجاد توازن میان منافع گوناگون است؛ توازنی که اغلب نمیتوان آن را بهطور کامل برقرار کرد. بااینحال، تا وقتی کل تیم بتواند در مسیر هدفی واحد با این بدهبستانها روبهرو شود و هرکس از جایگاه خود در پیشبرد هدف کلی سهم داشته باشد، این یک زیستبوم سالم است.»
Sam McCandlish: «بهنوعی، این یک «رقابت رو به بالا» است. بله، واقعاً یک «رقابت رو به بالا» است. گرچه این انتخاب بدون ریسک نیست و ممکن است همهچیز بهاشتباه پیش برود، اما همه توافق داریم: «این انتخابی است که کردهایم.»»
رقابت برای رسیدن به اوج هوش مصنوعی
Jack Clark: «اما بازار اساساً عملگراست؛ بنابراین هرچه Anthropic موفقتر شود، دیگران هم برای تقلید از الگوهای موفقیتی که ما را به اینجا رساندهاند انگیزه پیدا میکنند. همچنین وقتی موفقیت ما ارتباط نزدیکی با کار واقعیمان در حوزه ایمنی داشته باشد، این موفقیت نوعی «جاذبه» در صنعت ایجاد میکند و شرکتهای دیگر را به رقابت میکشاند. انگار ما کمربند ایمنی را اختراع کردهایم و دیگران هم میتوانند از آن پیروی کنند؛ این یک زیستبوم سالم است.»
Dario Amodei: «اما اگر همهجا بگویید «ما این فناوری را توسعه نمیدهیم و شما هم نمیتوانید آن را بهتر از بقیه بسازید»، این کار جواب نمیدهد، چون مسیر قابلاجرایی از زمان حال به آینده نشان ندادهاید. آنچه جهان نیاز دارد این است که یک صنعت یا شرکت راهی پیدا کند تا جامعه از «فناوری وجود ندارد» به «فناوری با توانایی بالا وجود دارد و جامعه آن را بهخوبی مدیریت میکند» گذر کند. فکر میکنم تنها راه رسیدن به این هدف این است که شرکتهای منفرد و در نهایت کل صنعت با این بدهبستانها روبهرو شوند.»
باید راهی پیدا کنید که رقابتی بمانید و حتی در بعضی حوزهها پیشتاز صنعت شوید، و همزمان ایمنی فناوری را تضمین کنید. اگر بتوانید این کار را انجام دهید، جذابیتتان برای صنعت بسیار زیاد خواهد بود. از محیطهای نظارتی گرفته تا استعدادهای برتری که میخواهند به شرکتتان بپیوندند و دیدگاه مشتریان، همه این عوامل صنعت را به یک سمت سوق میدهند. اگر ثابت کنید که میتوان بدون قربانیکردن رقابتپذیری به امنیت دست یافت و راهحلهایی پیدا کرد که به سود همه باشند، شرکتهای دیگر هم برای تقلید از این رفتار انگیزه پیدا میکنند.»
Jared Kaplan: «فکر میکنم به همین دلیل سازوکارهایی مثل RSP اهمیت زیادی دارند. میتوانیم بهروشنی ببینیم فناوری به کدام سمت میرود و لزوم هوشیاری زیاد درباره بعضی مسائل را درک کنیم، اما درعینحال نباید بیدلیل هشدار بدهیم و بگوییم «نوآوری باید همینجا متوقف شود». باید راهی پیدا کنیم تا فناوری هوش مصنوعی تجربهای مفید، نوآورانه و لذتبخش برای مشتریان فراهم کند و درعینحال محدودیتهایی را مشخص کنیم که باید به آنها پایبند بمانیم؛ محدودیتهایی که امنیت سیستم را تضمین میکنند و به شرکتهای دیگر نشان میدهند که آنها هم میتوانند در شرایط ایمن موفق شوند و با ما رقابت کنند.»
Dario Amodei: «چند ماه بعد، همزمان با اجرای RSP، سه شرکت برجسته هوش مصنوعی هم سازوکارهای مشابهی را معرفی کردند. پژوهش در زمینه تبیینپذیری نیز حوزه دیگری بود که در آن به پیشرفتهایی دست یافتیم. علاوهبراین، با سازمانهای پژوهشی ایمنی هوش مصنوعی همکاری کردیم و این تمرکز کلی بر امنیت، تأثیرات عمیقی دارد.»
Jack Clark: «بله، شرکتهای دیگر خیلی زود از Frontier Red Team تقلید کردند. این اتفاق خوبی است، چون امیدواریم همه آزمایشگاهها این آسیبپذیریهای امنیتی بالقوه و پرخطر را آزمایش کنند.»
Daniela Amodei: «Jack پیشتر هم اشاره کرد که مشتریان بهشدت نگران مسائل امنیتیاند. آنها نمیخواهند مدل اطلاعات نادرست تولید کند و نمیخواهند بهراحتی بتوان محدودیتهای امنیتی آن را دور زد. مشتریان میخواهند مدل مفید و بیضرر باشد. در گفتوگو با مشتریان، اغلب میشنویم که میگویند: «Claude را انتخاب کردیم چون میدانیم امنتر است.» فکر میکنم تأثیر این موضوع بر بازار بسیار زیاد است. ما میتوانیم مدلهایی قابلاعتماد و مطمئن ارائه دهیم و فشار زیادی بر رقبا در بازار وارد کنیم.»
Chris Olah: «شاید بتوانیم نکتهای را که Dario پیشتر گفت بیشتر بسط دهیم. عبارتی هست که میگوید اخلاقیترین رفتار، «شکست شرافتمندانه» است؛ یعنی باید برای امنیت، اهداف دیگر را قربانی کنید و حتی به شکلی غیرواقعبینانه عمل کنید تا خلوص نیتتان را در قبال ایمنی نشان دهید. اما فکر میکنم این رویکرد درواقع نتیجهای معکوس دارد.»
اول، این رویکرد باعث میشود تصمیمگیری به دست کسانی بیفتد که امنیت را در اولویت قرار نمیدهند. از سوی دیگر، اگر تلاش کنید راهی برای همراستا کردن انگیزهها پیدا کنید، تصمیمهای دشوار را به کسانی بسپارید که قدرت حمایت از تصمیمهای درست را دارند و تصمیمها را بر قویترین شواهد بنا کنید، میتوانید «رقابت رو به بالایی» را آغاز کنید که Dario توصیف کرد. در این رقابت، کسانی که به امنیت اهمیت نمیدهند به حاشیه رانده نمیشوند؛ بلکه دیگران ناچار میشوند از شما پیروی کنند و به این رقابت بپیوندند.»
آینده هوش مصنوعی
Jack Clark: «خب، برای کارهایی که قرار است در ادامه انجام دهیم، چه چیزهایی هیجانزدهتان میکند؟»
Chris Olah: «فکر میکنم دلایل زیادی برای هیجانزدهشدن درباره تبیینپذیری وجود دارد. یکی از دلایل آشکار، مسائل امنیتی است؛ اما دلیل دیگری هم هست که از نظر احساسی به همان اندازه برایم هیجانانگیز است: به نظرم شبکههای عصبی شگفتانگیزند و زیباییهای زیادی در آنها هست که هنوز ندیدهایم. همیشه با شبکههای عصبی مثل جعبه سیاه برخورد میکنیم و علاقه چندانی به ساختار درونی آنها نداریم، اما وقتی شروع به بررسی عمیقشان کنید، ساختارهای حیرتانگیزی درون آنها پیدا خواهید کرد.»
این موضوع کمی شبیه نگاه مردم به زیستشناسی است؛ بعضیها شاید فکر کنند: «تکامل خستهکننده است، فقط فرایندی ساده است که مدت زیادی ادامه پیدا کرده و بعد حیوانات را به وجود آورده است.» اما درواقع، هر حیوانی که تکامل به وجود آورده، سرشار از پیچیدگی و ساختار باورنکردنی است. به نظرم تکامل یک فرایند بهینهسازی است، درست مثل آموزش یک شبکه عصبی. درون شبکههای عصبی، ساختاری پیچیده شبیه «زیستشناسی مصنوعی» وجود دارد. اگر بخواهید عمیقتر بررسیشان کنید، چیزهای شگفتانگیز زیادی پیدا خواهید کرد.»
احساس میکنم تازه داریم آرامآرام پرده از راز آن برمیداریم. فوقالعاده جذاب است و چیزهای زیادی در انتظار کشفشدن هستند. تازه شروع به گشودن درها کردهایم و باور دارم کشفیات آینده بسیار هیجانانگیز و شگفتآور خواهند بود. گاهی تصور میکنم ده سال دیگر وارد کتابفروشی شوم و کتاب درسیای درباره تبیینپذیری شبکههای عصبی بخرم، یا کتابی که واقعاً به «زیستشناسی» شبکههای عصبی میپردازد و پر از مطالب شگفتانگیز است. باور دارم که در ده سال آینده، یا حتی چند سال آینده، واقعاً شروع به کشف این چیزها میکنیم و این مسیر سفری شگفتانگیز و حیرتآور خواهد بود.
Jack Clark: «چند سال پیش، اگر کسی میگفت «دولت یک نهاد جدید برای آزمایش و ارزیابی سیستمهای هوش مصنوعی تأسیس میکند و این نهادها بسیار حرفهای و اثرگذار خواهند بود»، شاید باور نمیکردید که چنین چیزی واقعاً رخ دهد. اما این اتفاق افتاده است. میتوان گفت دولت «سفارتخانههای جدیدی» برای رسیدگی به این دسته تازه از فناوری تأسیس کرده است و مشتاقم ببینم این موضوع به کجا میرسد. فکر میکنم این درواقع یعنی کشورها توانایی رسیدگی به چنین دگرگونیهای اجتماعی را دارند و لازم نیست فقط به شرکتها تکیه کنند؛ خوشحالم که بخشی از این ماجرا هستم.»
Daniela Amodei: «از همین حالا برای این موضوع هیجانزدهام، اما فکر میکنم فقط تصور کارهایی که هوش مصنوعی آینده میتواند برای بشریت انجام دهد هم بهاندازهای هیجانانگیز است که نتوان در برابرش هیجانزده نشد. حتی همین حالا هم نشانههایی که میگویند Claude میتواند به ساخت واکسن، پژوهش درباره سرطان و پژوهش زیستی کمک کند، باورنکردنیاند. دیدن کارهایی که اکنون میتواند انجام دهد شگفتانگیز است و وقتی سه تا پنج سال آینده را تصور میکنم و به این فکر میکنم که Claude واقعاً بسیاری از مشکلات بنیادین پیش روی ما انسانها، بهخصوص در حوزه سلامت، را حل کند، بسیار هیجانزده میشوم. وقتی به دوران کارم در حوزه توسعه بینالمللی فکر میکنم، کمکگرفتن از Claude برای کارهای ناکارآمدی که آن زمان انجام میدادم، فوقالعاده میبود.»
Tom Brown: «از دیدگاه شخصی، واقعاً از استفاده از Claude در کارم لذت میبرم. اخیراً در خانه هم از Claude استفاده میکنم و درباره بعضی موضوعات با آن گفتوگو میکنم؛ بزرگترین تغییر اخیر هم در برنامهنویسی بوده است. شش ماه پیش در خانه از Claude برای هیچ کاری مرتبط با برنامهنویسی استفاده نکرده بودم و تیم ما هم چندان از Claude برای کدنویسی استفاده نمیکرد، اما حالا این وضعیت بهطور چشمگیری تغییر کرده است. برای مثال، هفته گذشته در رویدادی که Y Combinator برگزار کرده بود سخنرانی کردم. در آغاز از همه پرسیدم: «چند نفر از شما اکنون برای برنامهنویسی از Claude استفاده میکنید؟» تقریباً %95 افراد دستشان را بالا بردند. تقریباً همه افراد حاضر در سالن دستشان را بالا بردند؛ این وضعیت با چهار ماه پیش کاملاً متفاوت است.»
Dario Amodei: «وقتی به چیزهایی فکر میکنم که هیجانزدهام میکنند، به حوزههایی میرسم که به نظر میآید دربارهشان به توافق رسیدهایم، اما درواقع در آستانه بهچالشکشیدن همان توافق هستیم؛ یکی از آنها تبیینپذیری است. باور دارم تبیینپذیری نهتنها برای هدایت و تضمین ایمنی سیستمهای هوش مصنوعی کلیدی است، بلکه بینشهای عمیقی درباره بهینهسازی هوشمندانه و نحوه کارکرد مغز انسان هم در خود دارد؛ قبلاً گفتهام که Chris Olah در آینده جایزه نوبل پزشکی را میبرد.»
چون قبلاً عصبشناس بودم، گمان میکنم بسیاری از مشکلات سلامت روان که هنوز حل نکردهایم، مثل اسکیزوفرنی یا اختلالات خلقی، به نوعی مسئله سیستمی در سطوح بالاتر مربوط باشند. اما این مسائل بهدلیل پیچیدگی مغز انسان و دشواری مطالعه آن، بهسختی بهطور کامل درک میشوند. شبکههای عصبی، بااینکه قیاسی کامل نیستند، بهاندازه مغز انسان مبهم و غیرقابلتعامل نیستند و با گذشت زمان به ابزاری قیاسی بهتر تبدیل خواهند شد.
حوزه مرتبط دیگر، کاربرد هوش مصنوعی در زیستشناسی است. زیستشناسی مسئلهای بسیار پیچیده است و به دلایل مختلف، مردم همچنان درباره آن تردید دارند؛ اما فکر میکنم این اجماعِ مبتنی بر تردید در حال تضعیفشدن است. دیدهایم که AlphaFold در حوزه شیمی جایزه نوبل دریافت کرده است؛ دستاوردی چشمگیر که باید بر پایه آن ابزارهایی توسعه دهیم تا بتوانیم صدها نسخه «AlphaFold» بسازیم.»
در نهایت، استفاده از هوش مصنوعی برای تقویت دموکراسی است. نگرانیم که اگر هوش مصنوعی بهدرستی توسعه پیدا نکند، به ابزاری برای اقتدارگرایی تبدیل شود. پس چگونه هوش مصنوعی را به ابزاری برای ترویج آزادی و حق تعیین سرنوشت تبدیل کنیم؟ باور دارم پیشرفت در این حوزه شاید کمی زودتر از دو حوزه نخست باشد، اما اهمیت آن به هیچوجه کمتر از آن دو نیست.
Jared Kaplan: «فکر میکنم دستکم دو نکته وجود دارد که با حرفهای قبلی شما همخوانی دارند. یکی این است که به نظرم بسیاری از افراد بهخاطر کنجکاوی فراوان درباره علم هوش مصنوعی به Anthropic میپیوندند. با پیشرفت فناوری هوش مصنوعی، کمکم متوجه میشوند که نهتنها باید توسعه فناوری را پیش ببریم، بلکه باید درکمان از آن را عمیقتر کنیم و ایمنیاش را هم تضمین کنیم. کارکردن با افراد بیشتری که دیدگاهی مشترک درباره توسعه هوش مصنوعی و مسئولیتپذیری دارند برایم هیجانانگیز است و فکر میکنم پیشرفتهای فناورانه زیادی در سال گذشته واقعاً به شکلگیری این اجماع کمک کردهاند.»
جنبه دیگر، بازگشت به مسائل عملی است؛ فکر میکنم کارهای زیادی در زمینه ایمنی هوش مصنوعی انجام دادهایم. اما با برخی تحولات اخیر، تازه در حال شکلدادن به درکی اولیه از خطرهایی هستیم که سیستمهای بسیار پیشرفته ممکن است ایجاد کنند. این موضوع به ما اجازه میدهد این خطرها را مستقیماً از طریق پژوهش در زمینه تبیینپذیری و انواع دیگر سازوکارهای امنیتی مطالعه و بررسی کنیم.»
با این رویکرد میتوانیم درک روشنتری از خطرهایی به دست آوریم که سیستمهای پیشرفته هوش مصنوعی ممکن است ایجاد کنند و مأموریتمان را به شیوهای علمیتر و مبتنی بر شواهد پیش ببریم. به همین دلیل، برای شش ماه آینده بسیار هیجانزدهام؛ در این مدت از درکمان درباره مشکلات احتمالی سیستمهای پیشرفته استفاده میکنیم تا پژوهش را بیشتر پیش ببریم و راههایی برای جلوگیری از این دامها پیدا کنیم.
این محتوا صرفاً برای اطلاعرسانی عمومی ارائه شده است و بهمنزله مشاوره مالی، سرمایهگذاری، حقوقی یا مالیاتی تلقی نمیشود. هرگونه رویداد، جایزه، کمپین آنلاین یا اطلاعات مرتبط که در اینجا ذکر شده است، نباید بهعنوان توصیه، ترغیب یا دعوت به خرید، فروش، معامله یا هرگونه دادوستد دیگر داراییهای رمزارزی تلقی شود. داراییهای رمزارزی از نوسان بالایی برخوردار هستند و ممکن است منجر به زیان شوند. دسترسی به خدمات، محصولات و رویدادهای مرتبط با WEEX ممکن است بسته به منطقه جغرافیایی متفاوت باشد. اطمینان از اینکه استفاده شما از این خدمات با قوانین و مقررات محلی مطابقت دارد، بر عهده خود شماست.
ممکن است شما نیز علاقهمند باشید

درآمد سالانه ۴۵.۹ میلیارد دلار، ارزشگذاری ۲ تریلیون دلار، آنتروپیک در تلاش برای بالاترین IPO تاریخ

برنامه Fairshake برای سرمایهگذاری 30 میلیون دلار علیه Sherrod Brown

چگونه 818 Tequila استانداردهای تازهای در برندسازی مدرن تعیین میکند

چرا بیشتر پروتکلهای DeFi در سال 2021 از بین رفتند؟

سهام و ارزهای دیجیتال مرتبط با هوش مصنوعی که سیترینی به آنها توجه کرده است... 8 شرکت ثبت شده و 1 ETF و 15 ارز دیجیتال

متخصصان درباره نیاز به آموزش مالی در عصر فینتک هشدار میدهند

استارتاپ هوش مصنوعی Manus پس از لغو خرید ۲ میلیارد دلاری متا توسط چین، ۵۰۰ میلیون دلار جذب کرد

گوگل کلود خدمات بلاکچین را متوقف کرده و مهلت نهایی برای مهاجرت به کوئیکنود را اعلام میکند

گسترش نگهداری رمزارزهای تحت نظارت BNY در اتحادیه اروپا تحت MiCA
اقتصاددانی که بیتکوین را «انقلابی» خواند، در میان نامزدهای مورد علاقه برای جایزه نوبل اقتصاد ۲۰۲۶ قرار دارد

چرا 63 میلیارد توکن در گردش XRP به خریداران نمیگوید چه چیزی برای فروش است

ACAMS و Chainalysis برنامه آموزشی جرمهای مالی رمزنگاری را گسترش میدهند در حالی که خسارات ناشی از کلاهبرداری به 17 میلیارد دلار میرسد

فدرال: زمینهای در بین اعضای خود برای افزایش جدید نرخها قبل از پایان سال در حال رشد است

انتقال بیتکوین به ارزش ۸.۳ میلیون دلار از دوران ساتوشی پس از ۱۶ سال

یوروپل میگوید ارتقاء کوانتومی ارزهای دیجیتال ممکن است سالها طول بکشد و خواستار شروع کار از هماکنون است

از وب3 به اقتصاد واقعی: Erable° به بازیگری کلیدی در تأمین مالی تأثیرگذار تبدیل میشود

درک پول دیجیتال و بازده دیجیتال

قیمت کوین XDP پس از لیست شدن در سپتامبر به زیر $0.02 سقوط کرد: دلیل افت پس از عرضه Doppler Finance چیست؟

کیف پول لجر – اکتبر 2026: گردش ارزهای دیجیتال بدون از دست دادن کنترل

یک حادثه ۱۰۰۰ دلاری MetaMask میتواند صف استیکینگ اتریوم را به ترافیک ۵ میلیارد دلاری تبدیل کند

بازار وامگیری با وثیقه سهام آمریکایی راهاندازی شد

سامسونگ و سولانا ارزهای دیجیتال را به میلیونها تلفن همراه میآورند: 'شکست بزرگ'

چرا مزیت نقدینگی بیتکوین مهم است در حالی که مؤسسات وارد میشوند

میکائیل سیلور دیگر: مهندس، کارآفرین و طرفدار داستانهای علمی تخیلی در سه دهه

هشدار رمزگشایی هوش مصنوعی... مدیرعامل بیتگو: "هک بیتکوین غیرممکن است" (خلاصه)

۳ آلت کوین با پتانسیل رشد بالا در حوزه DePIN که بهتر است زیر نظر داشته باشید!

Money20/20 USA 2026: چگونه بیتکوین، استیبلکوینها و هوش مصنوعی آینده مالی را متحول میکنند
60% از دارندگان ارزهای دیجیتال میخواهند سرمایهگذاریهای خود را افزایش دهند
TOKEN2049 سنگاپور 2026: WEEX چگونه معاملات هوش مصنوعی، TradFi و بازارهای چنددارایی را پیش میبرد
ترندهای کلیدی TOKEN2049 سنگاپور 2026 در معاملات هوش مصنوعی، توکنیزهسازی و TradFi را بررسی کنید و ببینید WEEX چگونه اکوسیستم معاملات چنددارایی خود را توسعه میدهد.

David Schwartz در برابر مدیرعامل Flare: اندازه وامدهی در XRP Ledger چقدر میتواند بزرگ باشد؟
درآمد سالانه ۴۵.۹ میلیارد دلار، ارزشگذاری ۲ تریلیون دلار، آنتروپیک در تلاش برای بالاترین IPO تاریخ
برنامه Fairshake برای سرمایهگذاری 30 میلیون دلار علیه Sherrod Brown
چگونه 818 Tequila استانداردهای تازهای در برندسازی مدرن تعیین میکند
چرا بیشتر پروتکلهای DeFi در سال 2021 از بین رفتند؟
سهام و ارزهای دیجیتال مرتبط با هوش مصنوعی که سیترینی به آنها توجه کرده است... 8 شرکت ثبت شده و 1 ETF و 15 ارز دیجیتال
متخصصان درباره نیاز به آموزش مالی در عصر فینتک هشدار میدهند


