
Intel se une a SK Hynix para lanzar una solución que rompe el cuello de botella de la inferencia de IA

 Califícanos en Google


"No es suficiente contar solo con una potencia de cálculo GPU adecuada para la IA; es necesario complementarla con una CPU que coordine, gestione y ejecute las tareas de IA."
El vicepresidente y gerente general de productos de IA y estrategia de mercado de Intel, Anil Nanduri, hizo esta declaración el 12 de diciembre en la cumbre de IA de Intel 2026 celebrada en el COEX de Gangnam, Seúl. Intel presentó en esta cumbre su hoja de ruta tecnológica de IA y planes de implementación en la industria, y anunció la creación de la Alianza K-AI, que cuenta con la participación inicial de 23 empresas e instituciones locales de Corea del Sur. {#quote_INTC}
Intel considera que, a medida que se popularizan los agentes de IA capaces de planificar y ejecutar múltiples tareas de forma autónoma, la colaboración entre CPU, GPU y chips de aceleración dedicados se vuelve cada vez más importante. Su enfoque es aprovechar las ventajas de diferentes semiconductores para crear computación heterogénea, reduciendo así los costos y la presión de consumo de energía en la etapa de inferencia de IA, que es el proceso mediante el cual la IA genera resultados basados en el contenido que ha aprendido.
SK Hynix, por su parte, está trabajando desde el lado del almacenamiento para mejorar la eficiencia de la lectura y escritura de datos, apoyando esta arquitectura. La compañía ha propuesto una solución de piscina de memoria de gran capacidad independiente de los servidores CPU y GPU, que permite el uso compartido entre múltiples servidores; para satisfacer la creciente demanda de potencia de cálculo de IA, SK Hynix está colaborando con clientes y socios para validar la tecnología de memoria compartida y ha comenzado a colaborar con Intel desde la etapa de diseño del sistema.
El vicepresidente y responsable de arquitectura de sistemas de SK Hynix, en su discurso sobre "Tecnologías de almacenamiento y diseño de sistemas en la era de la IA", afirmó: "En la era de los agentes de IA, el valor de la CPU aumenta y la competitividad de Intel está bajo un intenso escrutinio. Al redefinir el papel de la memoria en el sistema, esperamos mejorar significativamente el rendimiento general y la eficiencia energética."
La CPU se encarga de coordinar las tareas
Bajo una única solicitud de usuario, el agente de IA necesita completar una serie de tareas como la recuperación de datos, la ejecución de programas y la verificación de resultados. Nanduri dijo: "Los agentes necesitan inferir e interactuar repetidamente para generar respuestas, lo que consume una gran cantidad de tokens y aumenta los costos. La infraestructura debe diseñarse de acuerdo con las características de estas tareas para mejorar la eficiencia y reducir costos."
Los servidores CPU Xeon de Intel ocupan una posición central en la coordinación de tareas. La serie Xeon 6+, lanzada en el segundo trimestre de este año, puede integrar hasta 288 núcleos de cálculo de bajo consumo, capaces de manejar múltiples tareas simultáneamente.
La CPU clasifica las solicitudes y las asigna a los modelos de IA adecuados, gestionando la ejecución del programa y la seguridad; la GPU ejecuta el modelo y se encarga del cálculo para generar resultados; para escenarios que requieren baja latencia, Intel ha introducido servidores dedicados de la empresa estadounidense de chips de IA Samba Nova.
El GPU de inferencia en desarrollo, Crescent Island, cuenta con una gran capacidad de memoria y admite la ejecución simultánea de múltiples modelos. La versión de Intel está equipada con LPD DR5X, con una memoria de video de hasta 160 GB, mientras que la versión de los socios puede alcanzar hasta 480 GB.
Nanduri reveló que ya se ha logrado una demostración de generación de video a partir de texto con una sola tarjeta, pero "el hardware y el software aún no han alcanzado los estándares de producción en masa". Al hablar sobre la proporción de CPU, GPU y servidores, afirmó: "La combinación óptima depende del tipo de tarea y de la planificación de la infraestructura."
SK Hynix: la arquitectura de memoria compartida reduce el tiempo de respuesta del primer token de 80 segundos a 15 segundos
La división de las unidades de cálculo se está volviendo cada vez más detallada, y la importancia de la lectura y escritura de almacenamiento sigue en aumento. Sin embargo, actualmente, la HBM generalmente se despliega vinculada a la GPU, lo que limita el espacio de expansión de la memoria. El vicepresidente de SK Hynix afirmó: "La tecnología de apilamiento 3D aún está en desarrollo, pero la demanda está creciendo demasiado rápido y los clientes no pueden esperar. Estamos intentando resolver el cuello de botella desde el nivel del sistema."
SK Hynix ha propuesto una solución de chasis de memoria: los servidores conservan su memoria original y se equipan con dispositivos de memoria compartida, que son utilizados por múltiples servidores. Después de que la GPU completa un ciclo de cálculo, almacena los resultados en la memoria compartida y luego asume la siguiente tarea; cuando se necesita ese dato más adelante, otras GPUs pueden leerlo directamente.
El vicepresidente de SK Hynix comparó: "Es como si cada casa tuviera dos o tres coches, o si todos compartieran un solo coche; ¿cuál es más eficiente? Esta solución mejora la utilización y escalabilidad de la memoria, logrando una reducción de costos en todo el sistema."
La memoria compartida también puede reducir el cálculo repetido de la IA. La IA almacena resultados intermedios en un caché KV para su reutilización en inferencias posteriores; a medida que las conversaciones se alargan y el caché se acumula, la memoria local de la GPU puede agotarse, y el sistema solo puede eliminar el caché y recalcular. Al colocar el caché en una memoria compartida independiente, se puede evitar el cálculo repetido.
En las pruebas comparativas con socios: la solución de eliminar el caché y recalcular tuvo un tiempo promedio de 80.76 segundos para generar el primer token; al colocar el caché en un SSD externo, el tiempo se redujo a 33.56 segundos; y con la solución de DRAM remota basada en CXL, solo se necesitó 15.45 segundos, lo que representa una reducción de aproximadamente el 81% en la velocidad de respuesta en comparación con la solución de recalculo.
El vicepresidente de SK Hynix dijo: "Leer datos desde la memoria interconectada CXL tiene una latencia mayor que la memoria local conectada directamente a la GPU/CPU, pero en comparación con el cálculo repetido, el rendimiento sigue teniendo una ventaja significativa."
Expansión a dispositivos médicos y fábricas sin personal
El enfoque de Intel de combinar chips y software según las tareas también se aplica a los escenarios médicos e industriales. En entornos con limitaciones de espacio y energía, lograr capacidades de IA con el hardware mínimo es clave.
Samsung Madison, aprovechando la potencia de cálculo de IA integrada en el procesador Core Ultra y el software Open VINO, ha logrado medir automáticamente el grosor de las barreras de imágenes ultrasónicas. Intel afirma que esta solución no requiere una GPU independiente y que el rendimiento de inferencia de IA es 4.2 veces superior al de soluciones anteriores.
Intel también ha colaborado con Daimler Technologies para desarrollar un modelo de diseño para fábricas sin personal, integrando robots, equipos de producción y sistemas logísticos. En el negocio de chips personalizados, Intel propone combinar el diseño propio de los clientes con sus propios chips pequeños para aumentar la funcionalidad de manera flexible.
Esta cumbre tiene como objetivo conectar las aplicaciones y colaboraciones de IA desde centros de datos y PC hasta el sector industrial. La Alianza K-AI tiene como objetivo ayudar a los clientes locales a construir y operar sus propios sistemas de IA, aprovechando los servidores, chips, software y soluciones industriales locales de Corea del Sur.
El vicepresidente y gerente general de Intel para la región de Asia-Pacífico, Santosh Viswanathan, declaró: "Una de las ventajas de Intel es ayudar a la innovación de nuestros socios a llegar al mercado global. También podemos colaborar estrechamente para suministrar los productos de las empresas coreanas a los clientes globales que los necesiten."
Precio de --
Este contenido se ofrece únicamente con fines informativos generales y no constituye un asesoramiento financiero, de inversión, legal ni fiscal. Cualquier evento, recompensa, promoción en línea o información relacionada que se mencione en el presente documento no debe considerarse como una recomendación, solicitud o invitación a comprar, vender, operar o de negociar de otra manera con cualquier criptoactivo. Los criptoactivos son sumamente volátiles y pueden provocar pérdidas. La disponibilidad de los servicios, productos y eventos relacionados de WEEX puede variar según la región. Tienes la responsabilidad de asegurarte de que tu participación esté de acuerdo con las leyes y regulaciones locales vigentes.
Te puede gustar
Space and Time, respaldado por Microsoft, lanza una plataforma para permitir que los agentes de IA verifiquen datos privados

Yang Tianzhen se adentra en el capital de riesgo: se une a Kimi y a la impulsora de inversiones Jiang Shanshan para competir en proyectos de IA

Pliant completa una ronda de financiación Serie C de 80 millones de dólares, liderada por Seaya Nova y Speedinvest
zkLink Nova sufre un ataque, ofrece un 20% de recompensa a hackers éticos

Respuesta del cofundador de Berachain a «Nova Digital tiene derecho al reembolso de una inversión de 25 M $»: el informe no es preciso ni completo y Nova sigue siendo uno de los mayores tenedores de tokens

Seminario: Historia de Hyperliquid y Finanzas On-Chain con el invitado Takuya Fujita (18/11 19:30 @ Gentoosha)
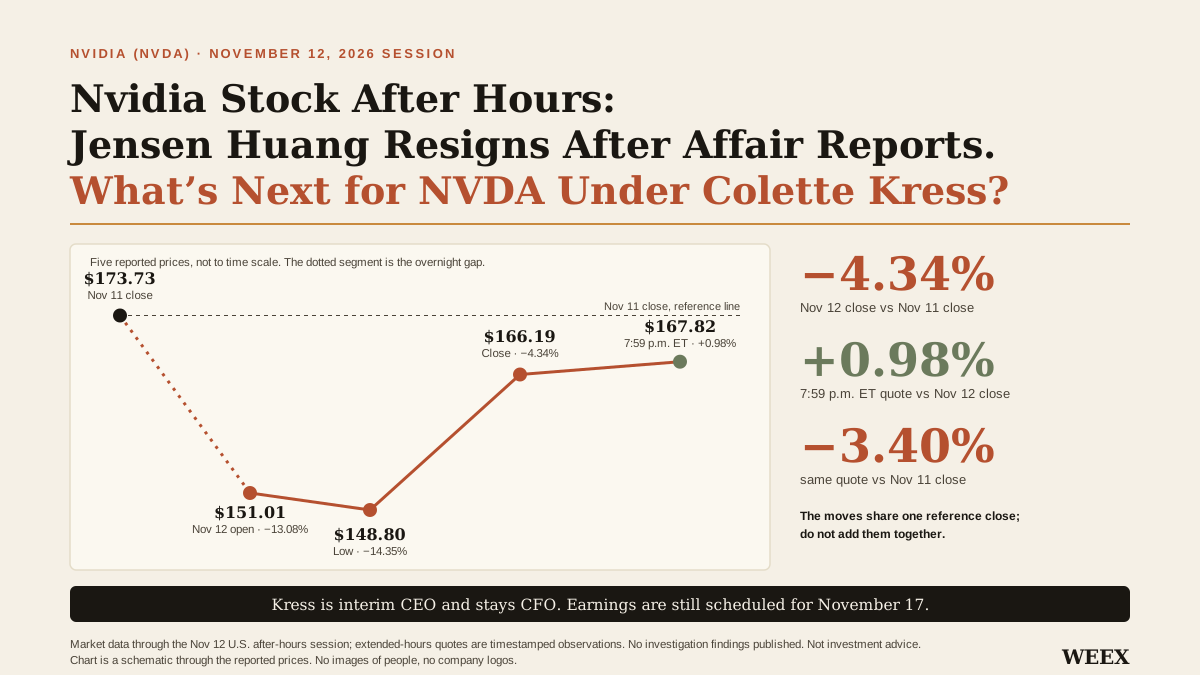
Acciones de Nvidia tras el cierre: Jensen Huang dimite tras informaciones sobre una aventura. ¿Qué le espera a NVDA con Colette Kress?
Nvidia cayó 4,34% tras la dimisión de Jensen Huang, pero subió 0,98% en las operaciones posteriores al cierre. Descubre qué significan el nombramiento de Colette Kress para NVDA y los resultados del 17/11.
Secuestro del «rey de la cripto»: la defensa clama que es un montaje
La dimisión del CEO de Nvidia impacta en las acciones tecnológicas; Bitcoin cae al soporte de 70.000$ | Resumen diario del mercado WEEX (13/11/2026)
Las ventas de acciones tecnológicas hicieron caer Bitcoin hasta el nivel de soporte de 70.000$, mientras que Ethereum bajó brevemente de 2.000$. Los ETF spot de Bitcoin registraron salidas netas por quinto día de trading consecutivo. La dimisión del CEO de Nvidia provocó una fuerte volatilidad en el precio de sus acciones. Las previsiones de Nebius para todo el año quedaron por debajo de las expectativas. El PPI de octubre es el dato clave que habrá que seguir el 13/11.

La propuesta de Aave apunta a 3,5 millones de dólares en ingresos anuales adicionales a través de cambios en los factores de reserva
La actualización Veyra de Injective se dirige a la votación de gobernanza antes del lanzamiento del 24 de noviembre

La salida repentina de Jensen Huang genera dudas: ¿intervino la Casa Blanca en secreto? ¿Es posible un regreso en el futuro?
¿Cómo evalúan las agencias de calificación externas la seguridad de los activos de WEEX?

Entrevista exclusiva|Fu Peng: No tengo fe en BTC
Cerebras firma un gran contrato con Microsoft, la escasez de HBM se convierte en una oportunidad, el chip WSE-5 se producirá en masa el próximo verano
Las acciones de SoundHound AI caen casi un 60% en 2026, pero Wall Street cree que pueden aumentar un 155% para finales de 2027. Aquí está el motivo por el que podría ser una de las mejores compras en medio de la venta masiva tecnológica.
Lo que se dice en las mesas: el mercado comienza a ver 2027 como un escenario de todo o nada

ASA presiona al tribunal para detener los perpetuos de acciones, poniendo el riesgo minorista en el centro de la lucha

El piloto de PNC con Coinbase convierte USDC entrante en depósitos bancarios comerciales
Un usuario de Aave pierde 305,000 dólares tras el secuestro del sitio web de Across Protocol
Circle y Global Citizen Planifican Pagos a Proveedores en USDC para Move Afrika en 2027

Los resultados del primer trimestre de Cisco superan las expectativas: se prevé que los ingresos por infraestructura de IA se dupliquen este año fiscal
¡Cerebras se dispara! Ingresos del tercer trimestre superan las expectativas, el negocio en la nube se dispara un 272%, se eleva la guía anual
BitGo y TOPPAN realizan una prueba de gestión de claves distribuidas para activos digitales
Bottomline Completa las Primeras Transferencias de USDC Dentro de Su Plataforma de Pagos Empresariales
Ethereum planea avanzar en su transición post-cuántica hacia 2027
El senador republicano quiere frenar el auge de los centros de datos de IA mientras el Congreso impulsa su expansión
La Operación TorNado del DOJ arresta a 354 y confisca 234 millones de dólares en efectivo y criptomonedas

Google lanza Gemini 4 Hydrogen: reducción de ilusiones cinco veces, velocidad duplicada

USDC entra en supervisión dual de la UE a medida que entra en vigor la supervisión de la EBA
Space and Time, respaldado por Microsoft, lanza una plataforma para permitir que los agentes de IA verifiquen datos privados
Yang Tianzhen se adentra en el capital de riesgo: se une a Kimi y a la impulsora de inversiones Jiang Shanshan para competir en proyectos de IA
Pliant completa una ronda de financiación Serie C de 80 millones de dólares, liderada por Seaya Nova y Speedinvest
zkLink Nova sufre un ataque, ofrece un 20% de recompensa a hackers éticos
Respuesta del cofundador de Berachain a «Nova Digital tiene derecho al reembolso de una inversión de 25 M $»: el informe no es preciso ni completo y Nova sigue siendo uno de los mayores tenedores de tokens
Seminario: Historia de Hyperliquid y Finanzas On-Chain con el invitado Takuya Fujita (18/11 19:30 @ Gentoosha)
Artículos recientes
Últimos listados de monedas en WEEX


